Python стал стандартом Data Science не случайно: код компактнее, чем в R и MATLAB, а экосистема охватывает весь аналитический пайплайн — от загрузки сырых данных до обучения нейросетей. Ядро — SciPy Stack (NumPy, SciPy, Matplotlib, pandas, Jupyter), на котором строятся специализированные инструменты. В статье разберём 12 библиотек Python для анализа данных по задачам: обработка таблиц, математические вычисления, машинное обучение, визуализация и нишевые инструменты.
Python обходит Excel при больших объёмах данных: одна строка кода заменяет сотни ручных операций. R силён в статистике, но проигрывает в production-развёртывании и объёме экосистемы. Ниже — основные библиотеки Python для анализа данных, сгруппированные по задачам, с уровнем входа и командами установки. Таблица служит навигацией по разделам статьи.
| Библиотека |
Задача |
Уровень |
pip install |
|---|---|---|---|
| pandas | Подготовка и очистка данных | Начальный | pip install pandas |
| NumPy | Числовые вычисления, массивы | Начальный | pip install numpy |
| SciPy | Научные вычисления | Продвинутый | pip install scipy |
| scikit-learn | Классическое ML | Средний | pip install scikit-learn |
| TensorFlow | Нейросети, глубокое обучение | Продвинутый | pip install tensorflow |
| Keras | Быстрое прототипирование сетей | Средний | встроена в TF 2.0+ |
| statsmodels | Статистика, проверка гипотез | Средний | pip install statsmodels |
| Matplotlib | 2D-визуализация (базовая) | Начальный | pip install matplotlib |
| seaborn | Статистические графики | Начальный | pip install seaborn |
| Plotly | Интерактивные и 3D-графики | Средний | pip install plotly |
| Bokeh | Веб-визуализация | Средний | pip install bokeh |
| Dash | Бизнес-дашборды | Средний | pip install dash |
SciPy Stack — фундамент всей научной экосистемы Python: NumPy, SciPy, Matplotlib, pandas и Jupyter. Все специализированные инструменты — scikit-learn, seaborn, statsmodels — строятся поверх этого ядра, а NumPy служит базовым слоем для большинства из них.
Главный инструмент подготовки данных. Центральный объект — DataFrame: таблица со строками и именованными столбцами. pandas принимает CSV, Excel, SQL, JSON и HTML, а ключевые операции — merge, groupby, pivot, fillna, dropna — покрывают полный цикл обработки данных в Python. Преимущество перед Excel очевидно: одна строка кода выполняет операцию над 10 000 строк без зависаний и ручной работы. Начинайте изучение библиотек numpy и pandas именно с pandas — она стоит первым этапом в любом аналитическом пайплайне.
NumPy предоставляет ключевой объект — ndarray (N-мерный массив) — для работы с векторами, матрицами и тензорами. Библиотека покрывает линейную алгебру, преобразования Фурье и генерацию случайных чисел; вычисления выполняются на уровне C и значительно быстрее чистого Python. На NumPy построены SciPy, scikit-learn, pandas и TensorFlow: освоить numpy и scipy без понимания ndarray не получится.
SciPy расширяет NumPy до уровня функциональности MATLAB: дифференциальные уравнения, интегралы, преобразования Фурье, генетические алгоритмы, обработка изображений и сигналов. Библиотека разбита на подпакеты по дисциплинам — выбираете нужный под конкретную задачу. SciPy также служит фундаментом для statsmodels и незаменима для прикладного анализа данных на Python.
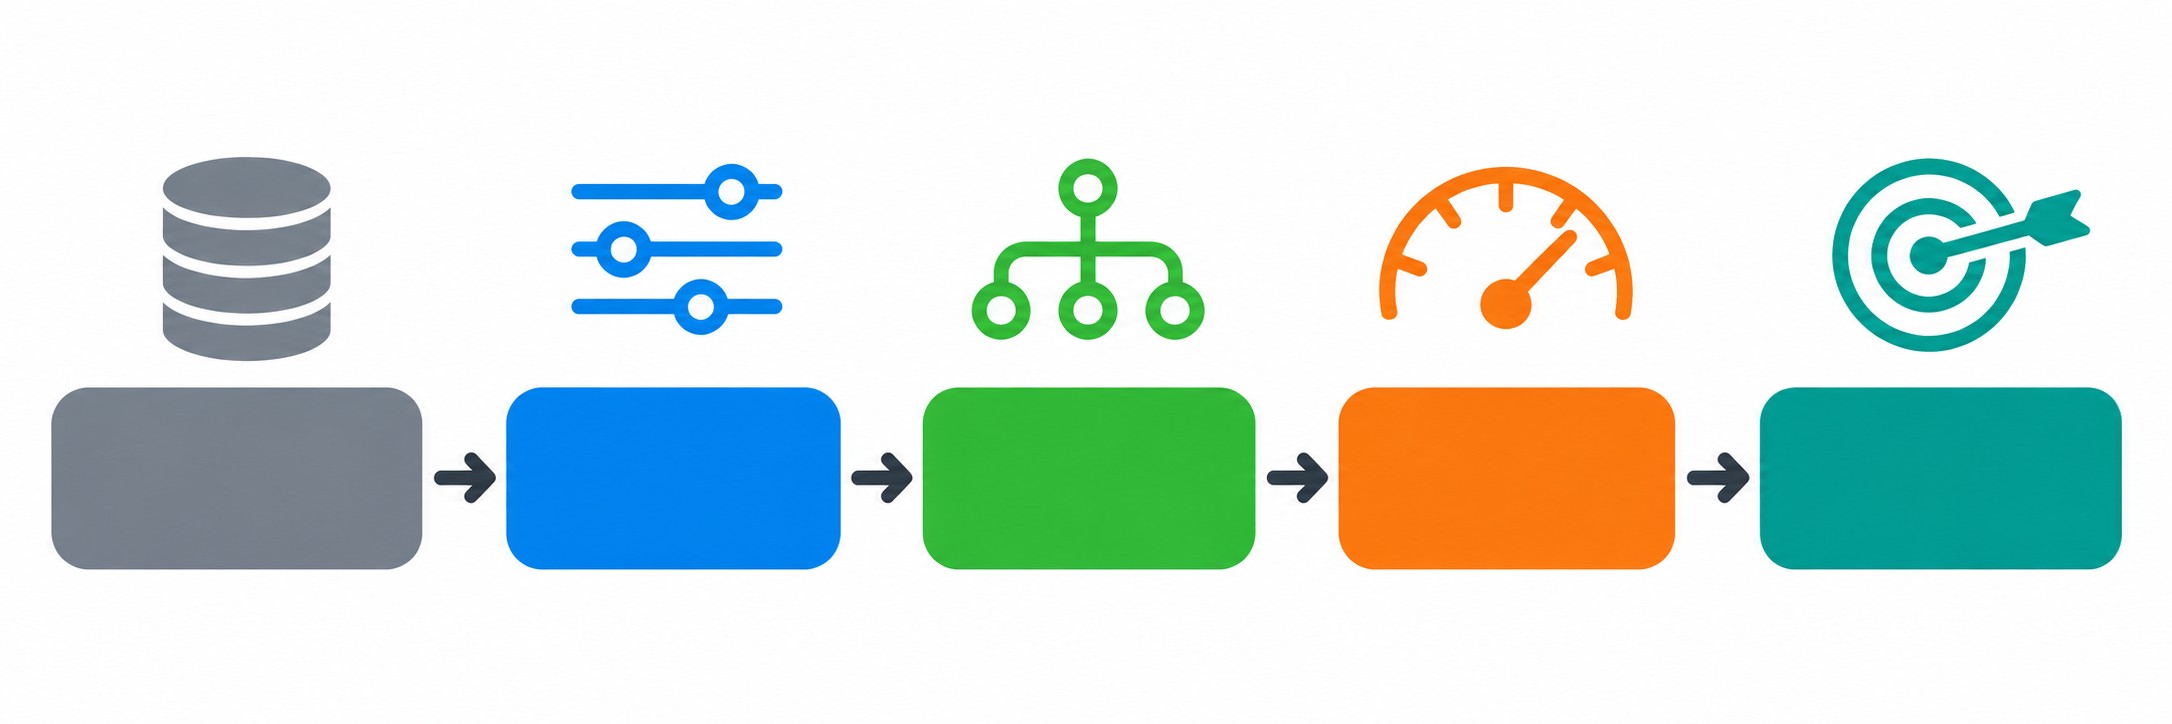
От подготовки данных — к построению моделей. Три направления: классическое машинное обучение (scikit-learn), нейросети (TensorFlow + Keras) и статистическое моделирование (statsmodels).
Если хотите разобраться с этими инструментами на практике и выстроить стек аналитика с нуля — изучите курсы по Data Science с разбором реальных задач на Python.
scikit-learn покрывает весь спектр классического машинного обучения: классификация, регрессия, кластеризация и снижение размерности. Supervised и unsupervised обучение доступны из коробки через единый API — не нужно изучать разные интерфейсы для каждого алгоритма. Реальные пользователи в production: Spotify, Evernote и OKCupid. Библиотека строится на NumPy и SciPy и включает встроенный механизм оценки и выбора моделей.
TensorFlow создан Google взамен внутреннего DistBelief и применяется для распознавания изображений и голоса. С версии TF 2.0 Keras полностью интегрирована в TensorFlow как высокоуровневый API — устанавливать её отдельно не нужно. Keras поддерживает CNN (свёрточные) и RNN (рекуррентные) нейронные сети и подходит для быстрого прототипирования: tensorflow.keras — стандартный путь к глубокому обучению нейронных сетей на Python.
statsmodels закрывает разрыв между Python и R в области статистики. Библиотека поддерживает R-формулы через встроенную Patsy и реализует линейную регрессию, байесовские и обобщённые линейные модели, проверку гипотез. Полностью совместима с pandas, NumPy, SciPy и Matplotlib — переключение с языка R требует минимальных усилий.
Иерархия инструментов выстроена по уровню абстракции: Matplotlib — базовый слой, seaborn — надстройка для статистических графиков, Plotly и Bokeh — интерактивность, Dash — бизнес-дашборды.
Matplotlib — низкоуровневая библиотека для 2D-визуализации данных: линейные, столбчатые, круговые, контурные графики, спектрограммы. Максимальный набор типов при полном контроле над каждым элементом. Цена — больше строк кода для каждого графика.
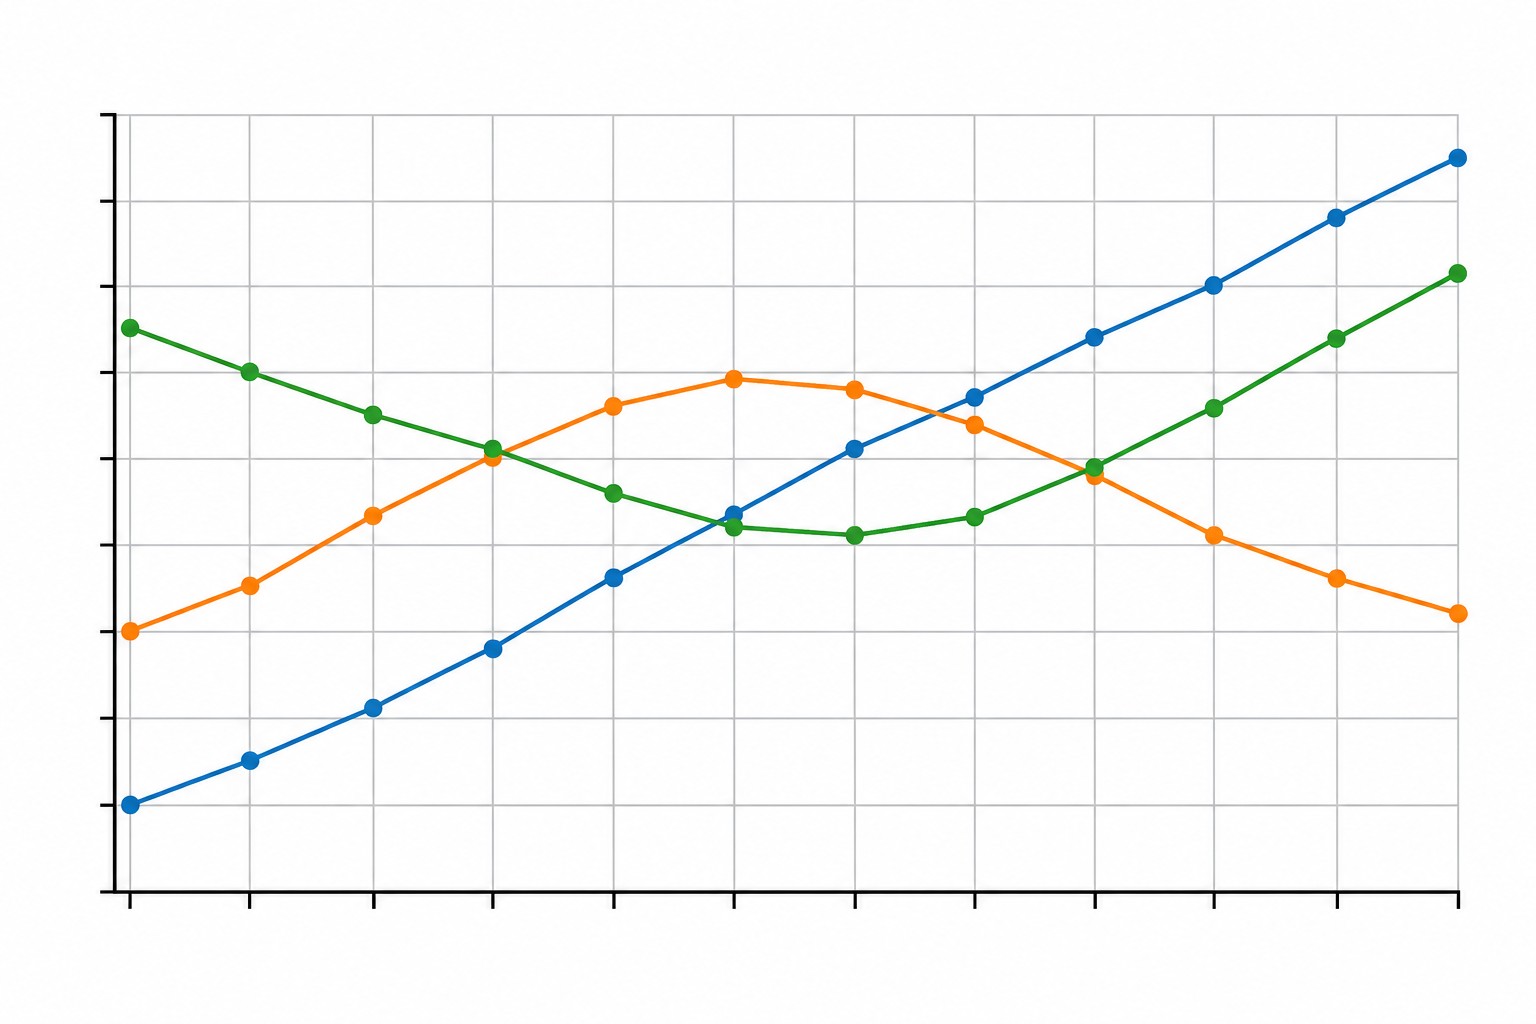
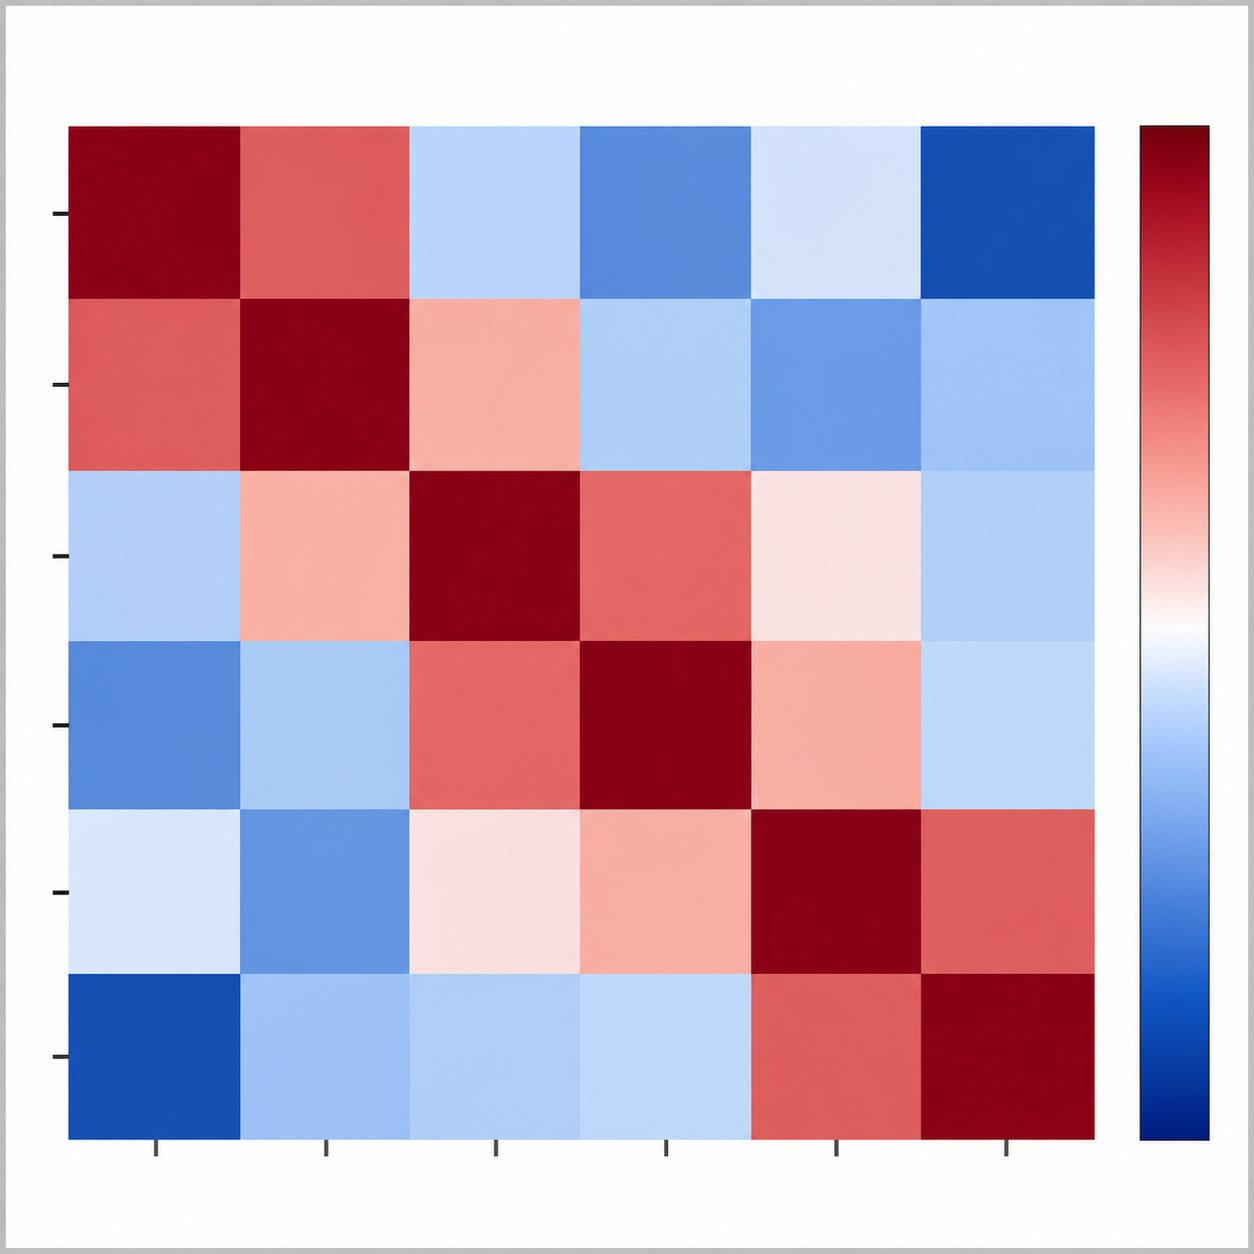
seaborn строится поверх Matplotlib и автоматизирует сложные статистические графики: тепловые карты, временные ряды, скрипичные диаграммы. Подходит нетехнической аудитории — красивый результат готов в несколько строк. Правило выбора простое: Matplotlib — для контроля, seaborn — для скорости и аккуратного результата при аналитике и визуализации данных на Python.
Хотите сменить профессию или повысить квалификацию?
Федеральный проект «Активные меры содействия занятости» даёт возможность пройти обучение бесплатно за счёт государства
Plotly добавляет hover-значения, интерактивные 3D-визуализации и экспорт в JSON — удобно для научных и финансовых карт. Dash строится поверх Plotly и позволяет собирать интерактивные дашборды для бизнес-отчётности без знания веб-разработки. Bokeh генерирует JS-виджеты напрямую: встраивание в Flask, автообновление графиков при изменении данных.
NLP, парсинг, граф-аналитика и интерактивная IDE — задачи за рамками классической работы с данными в питоне, но важные для полноценного Data Science стека.
NLTK отвечает за обработку естественного языка: анализ тональности, синтаксический разбор, извлечение именованных сущностей. Scrapy — фреймворк для spider-ботов: собирает цены, контакты, URL, извлекает данные из API. Pattern объединяет оба инструмента и добавляет ML: одна библиотека закрывает парсинг, NLP и обращение к API Google, Twitter и Wikipedia.
NetworkX создаёт и анализирует графы и сетевые структуры в стандартных и нестандартных форматах — актуально для задач социального анализа, маршрутизации и логистики. Jupyter — интерактивная IDE, аналог MATLAB и Mathematica: код, вывод и Markdown-описание в одном браузерном документе. JupyterHub разворачивает ту же среду для командной аналитики данных на Python на общем сервере.
Выбор зависит от задачи: таблицы — pandas, матричная математика — NumPy, классическое ML — scikit-learn, нейросети — TensorFlow с Keras, статистика — statsmodels, визуализация — Matplotlib или seaborn. Новичку подходит такой порядок: pandas → NumPy → Matplotlib → scikit-learn — путь через ядро SciPy Stack, принятый в большинстве Data Science программ. Продвинутый стек расширяется за счёт SciPy, statsmodels, TensorFlow и Keras. Главное правило: освойте pandas и NumPy до перехода к ML — это сэкономит месяцы отладки и переписывания кода. Подобрать направление и курсы по аналитике данных можно в каталоге на главной странице Free-edu.
Matplotlib — любые 2D-графики; seaborn — статистические диаграммы и тепловые карты; Plotly — интерактивная и 3D-визуализация; Bokeh — встраивание в браузер; Dash — бизнес-дашборды. Новичкам рекомендуется начать с Matplotlib: она входит в базовый SciPy Stack и устанавливается первой.
Оптимальный порядок: pandas → NumPy → Matplotlib → scikit-learn. Это путь через ядро SciPy Stack, принятый в большинстве Data Science курсов. Каждая следующая библиотека строится на предыдущей — прыгать через этапы не стоит.
Matplotlib — низкоуровневая, максимальный набор типов диаграмм, требует больше кода. seaborn — надстройка над Matplotlib: создаёт сложные статистические графики (тепловые карты, скрипичные диаграммы) несколькими строками. Для контроля над каждым пикселем выбирайте Matplotlib, для скорости — seaborn.
pandas работает с табличными данными (DataFrame — строки и столбцы с именами), NumPy — с числовыми массивами (ndarray). pandas использует NumPy внутри. Для анализа таблиц — pandas, для матричной математики и линейной алгебры — NumPy.
С версии TensorFlow 2.0 Keras полностью интегрирована в TF как высокоуровневый API — самостоятельная установка не нужна. Используйте tensorflow.keras для построения и обучения нейронных сетей: CNN, RNN и их комбинаций.
Для классического ML — scikit-learn (единый API; пользователи в production: Spotify, Evernote, OKCupid). Для нейросетей — TensorFlow с Keras. Для статистического моделирования и проверки гипотез — statsmodels. Выбор определяет тип задачи, а не личные предпочтения.
SciPy Stack — ядро научного Python: NumPy, SciPy, Matplotlib, pandas и Jupyter. Это экосистемная концепция, а не установочный пакет. Все специализированные библиотеки — scikit-learn, seaborn, statsmodels — опираются на NumPy как общий фундамент.
Да. statsmodels закрывает разрыв: поддерживает линейную регрессию, байесовские модели, проверку гипотез и R-стиль формул через встроенную Patsy. Специалисты с опытом в R адаптируются к statsmodels без значительных усилий.
Подайте заявку — забронируйте место в группе
45 000 мест на 2026 год. Бесплатное обучение по федеральному проекту «Активные меры содействия занятости»