Когда нужно узнать, сколько заказов сделал каждый клиент или какую выручку принёс каждый регион, — на помощь приходит GROUP BY. Это предложение SQL-запроса объединяет строки с одинаковыми значениями в группы и позволяет применять к каждой группе агрегатные функции: COUNT, SUM, AVG, MIN, MAX. Оператор GROUP BY в SQL выполняется на третьем шаге пайплайна — после WHERE и до HAVING. В статье разберём синтаксис, порядок выполнения, примеры с реальными запросами, разницу между WHERE и HAVING, отличие от ORDER BY, а также расширения T-SQL: ROLLUP, CUBE, GROUPING SETS.
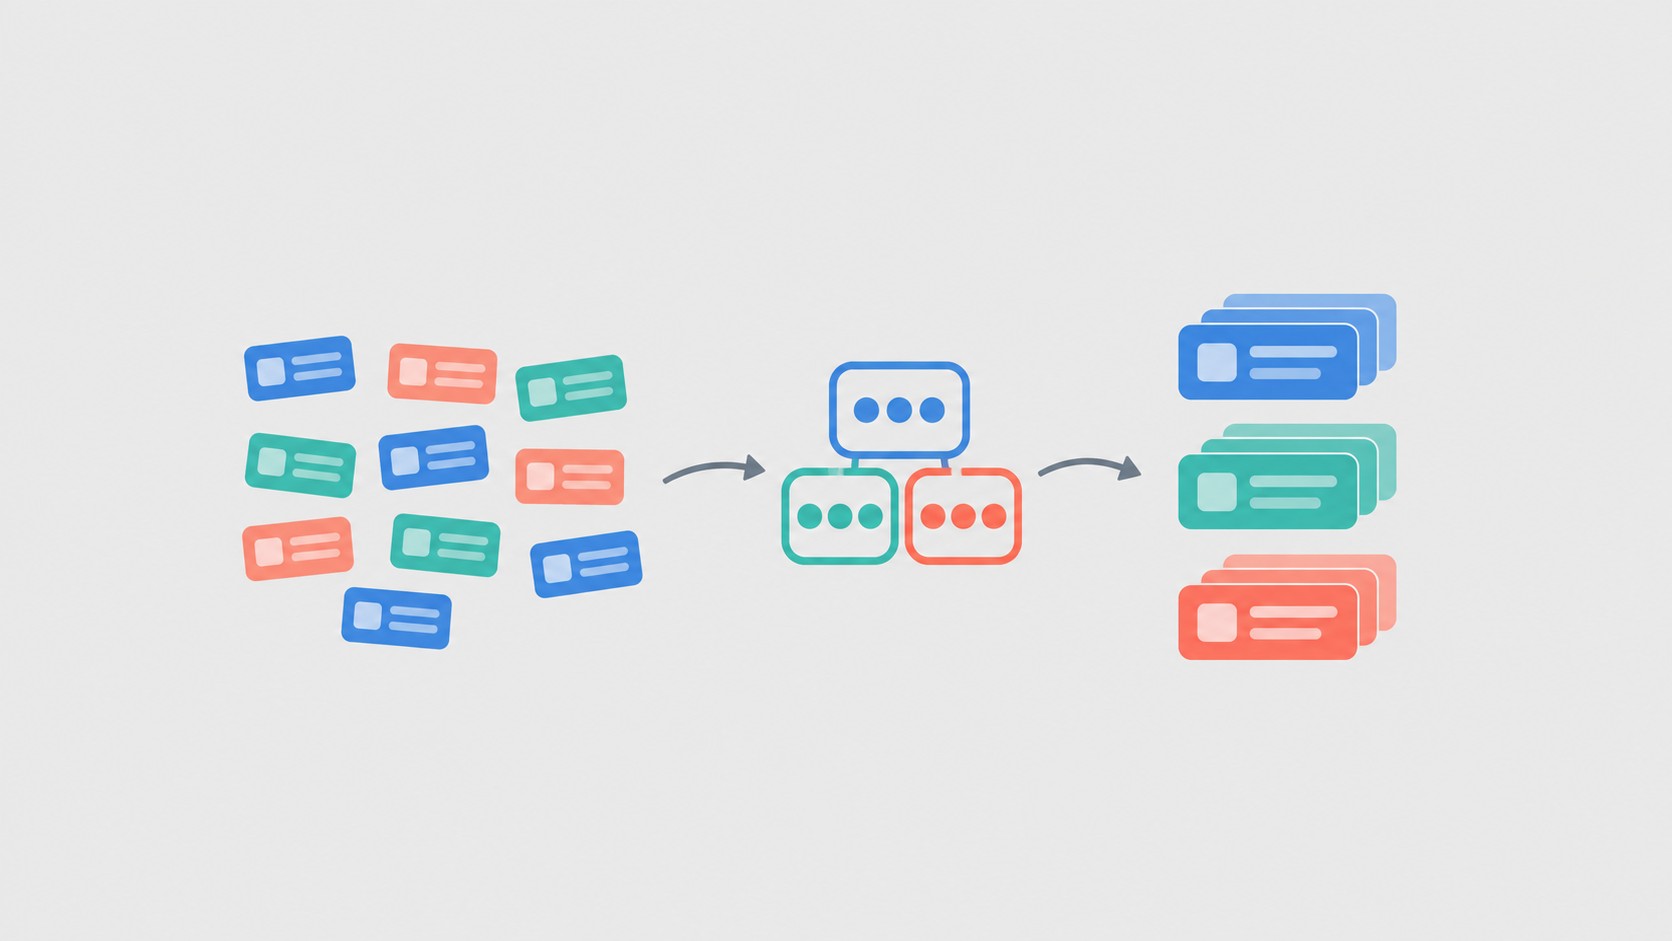
GROUP BY — предложение (clause) инструкции SELECT, которое собирает строки с одинаковым значением заданного столбца или нескольких столбцов в единую группу. Синтаксис стандартизирован в ISO/ANSI SQL-2006.
Ключевое правило: в списке SELECT после GROUP BY допустимы только столбцы из условия группировки, агрегатные функции и литералы. Поле, которое не входит в GROUP BY и не обёрнуто в агрегат, создаёт неоднозначность — СУБД не знает, какое из нескольких значений выбрать для группы. Большинство СУБД вернут ошибку синтаксиса.
Четыре типичных сценария, где группировка данных в SQL незаменима:
Базовая структура запроса с группировкой:
SELECT  [столбцы_группировки], [агрегатные_функции]
FROM    [таблица]
WHERE   [условие]            -- необязательно
GROUP BY [столбцы_группировки]
HAVING  [условие_для_групп]  -- необязательно
ORDER BY [порядок];          -- необязательно
Пример на таблице orders (поля: order_id, customer_id, amount):
-- Снипет 1: число заказов и сумма по каждому клиенту
SELECT
    customer_id,            -- поле из GROUP BY
    COUNT(*) AS orders_count,
    SUM(amount) AS total_amount
FROM orders
GROUP BY customer_id;       -- та же колонка, что в SELECT
Позиционная нотация GROUP BY 1 означает группировку по первому выражению в SELECT — удобно при длинных именах столбцов, но ухудшает читаемость кода при изменении порядка столбцов.
SQL-движок обрабатывает инструкцию SELECT не в том порядке, в котором она написана. Фактический порядок выполнения SQL-запроса:
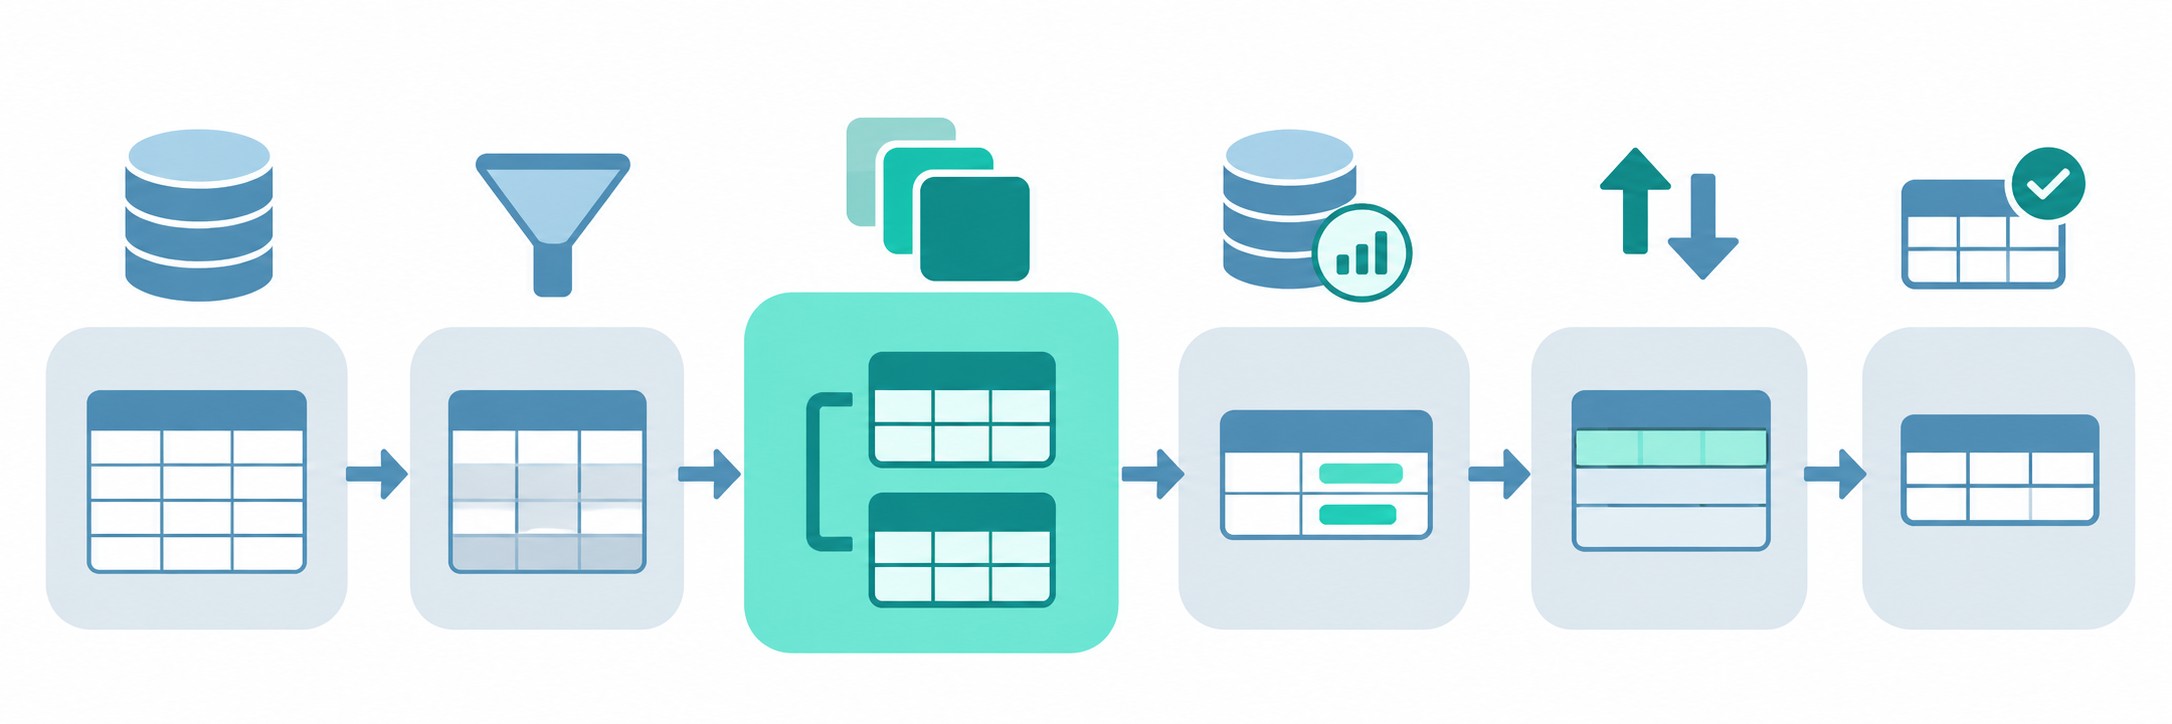
Понимание этого пайплайна объясняет три правила, которые иначе кажутся произвольными.
Почему WHERE не принимает агрегаты. На шаге 2 группы ещё не образованы — COUNT(*) просто не имеет смысла. Запрос WHERE COUNT(*) > 2 вернёт ошибку синтаксиса.
Почему HAVING принимает агрегаты. Шаг 4 наступает после группировки: значения COUNT, SUM и других функций уже рассчитаны, поэтому HAVING COUNT(*) > 2 работает корректно.
Почему ORDER BY видит псевдонимы из SELECT. Он выполняется последним — после того как SELECT определил все псевдонимы.
Рабочее правило: фильтрация строк — WHERE, группировка — GROUP BY, фильтрация групп — HAVING, сортировка — ORDER BY. Только в таком порядке.
Агрегатные функции вычисляют одно значение по набору строк в группе и чаще всего используются в паре с GROUP BY. Пять стандартных функций:
| Функция |
Что считает |
Поведение с NULL |
Пример |
|---|---|---|---|
| COUNT(*) | все строки в группе | считает | COUNT(*) = 5 |
| COUNT(col) | строки где col ≠ NULL | пропускает | COUNT(amount) = 4 |
| SUM(col) | сумма значений | пропускает | SUM(amount) = 1200 |
| AVG(col) | среднее (без NULL в знаменателе) | пропускает | AVG(amount) = 300 |
| MIN(col) / MAX(col) | минимум / максимум | пропускают | MIN(order_date) |
Если вы изучаете SQL с нуля и хотите разобраться с агрегациями и базами данных на практике, в рамках федерального проекта «Активные меры содействия занятости» доступна программа «Специалист по аналитике и базам данных в информационных системах» — бесплатно за счёт государства. Условия участия и другие направления — на главной странице free-edu.ru.
COUNT существует в трёх вариантах, и выбор между ними существенно влияет на результат:
-- Снипет 2: клиент с тремя заказами, один с amount = NULL
SELECT
    customer_id,
    COUNT(*)               AS orders_total,     -- 3: считает все строки
    COUNT(amount)          AS orders_with_sum,  -- 2: пропускает NULL
    COUNT(DISTINCT amount) AS unique_amounts    -- 2: только уникальные ненулевые
FROM orders
WHERE customer_id = 5
GROUP BY customer_id;
Правило: COUNT(*) — общее число строк в группе; COUNT(col) — только ненулевые значения; COUNT(DISTINCT col) — уникальные ненулевые.
Обе функции пропускают NULL при расчётах. SUM возвращает NULL, если в группе все значения равны NULL. AVG делит сумму на количество строк без NULL — то есть среднее не занижается нулями из-за пропущенных данных.
-- Снипет 3: сумма и среднее по клиентам с защитой от NULL
SELECT
    customer_id,
    SUM(amount)              AS total_amount,
    COALESCE(SUM(amount), 0) AS total_safe,  -- 0 вместо NULL
    AVG(amount)              AS avg_amount
FROM orders
GROUP BY customer_id;
Паттерн COALESCE(SUM(amount), 0) заменяет итоговый NULL на ноль и защищает отчёты от неожиданных пропусков.
MIN и MAX работают с числами, датами и строками (для строк применяется алфавитный порядок). Оба пропускают NULL.
-- Снипет 4: диапазон дат заказов по клиентам
SELECT
    customer_id,
    MIN(order_date) AS first_order,
    MAX(order_date) AS last_order
FROM orders
GROUP BY customer_id;
Так за один запрос находят дату первого и последнего заказа каждого клиента.
Четыре правила поведения NULL при группировке в SQL:
-- Снипет 5: защита итогового NULL через COALESCE
SELECT
    customer_id,
    COALESCE(SUM(amount), 0) AS total_amount
FROM orders
GROUP BY customer_id;
Важно не путать NULL в данных и NULL, который появляется в строках итогов ROLLUP и CUBE — там он обозначает агрегированный уровень, а не пропущенное значение.
Все примеры в разделе работают с таблицей orders_with_status (столбцы: order_id, status, payment_method, amount, order_date). Прогрессия: один столбец → несколько столбцов → уникальные значения внутри группы.
-- Снипет 6: количество и сумма заказов по статусу
SELECT
    status,
    COUNT(*) AS orders_count,
    SUM(amount) AS total_amount
FROM orders_with_status
GROUP BY status;
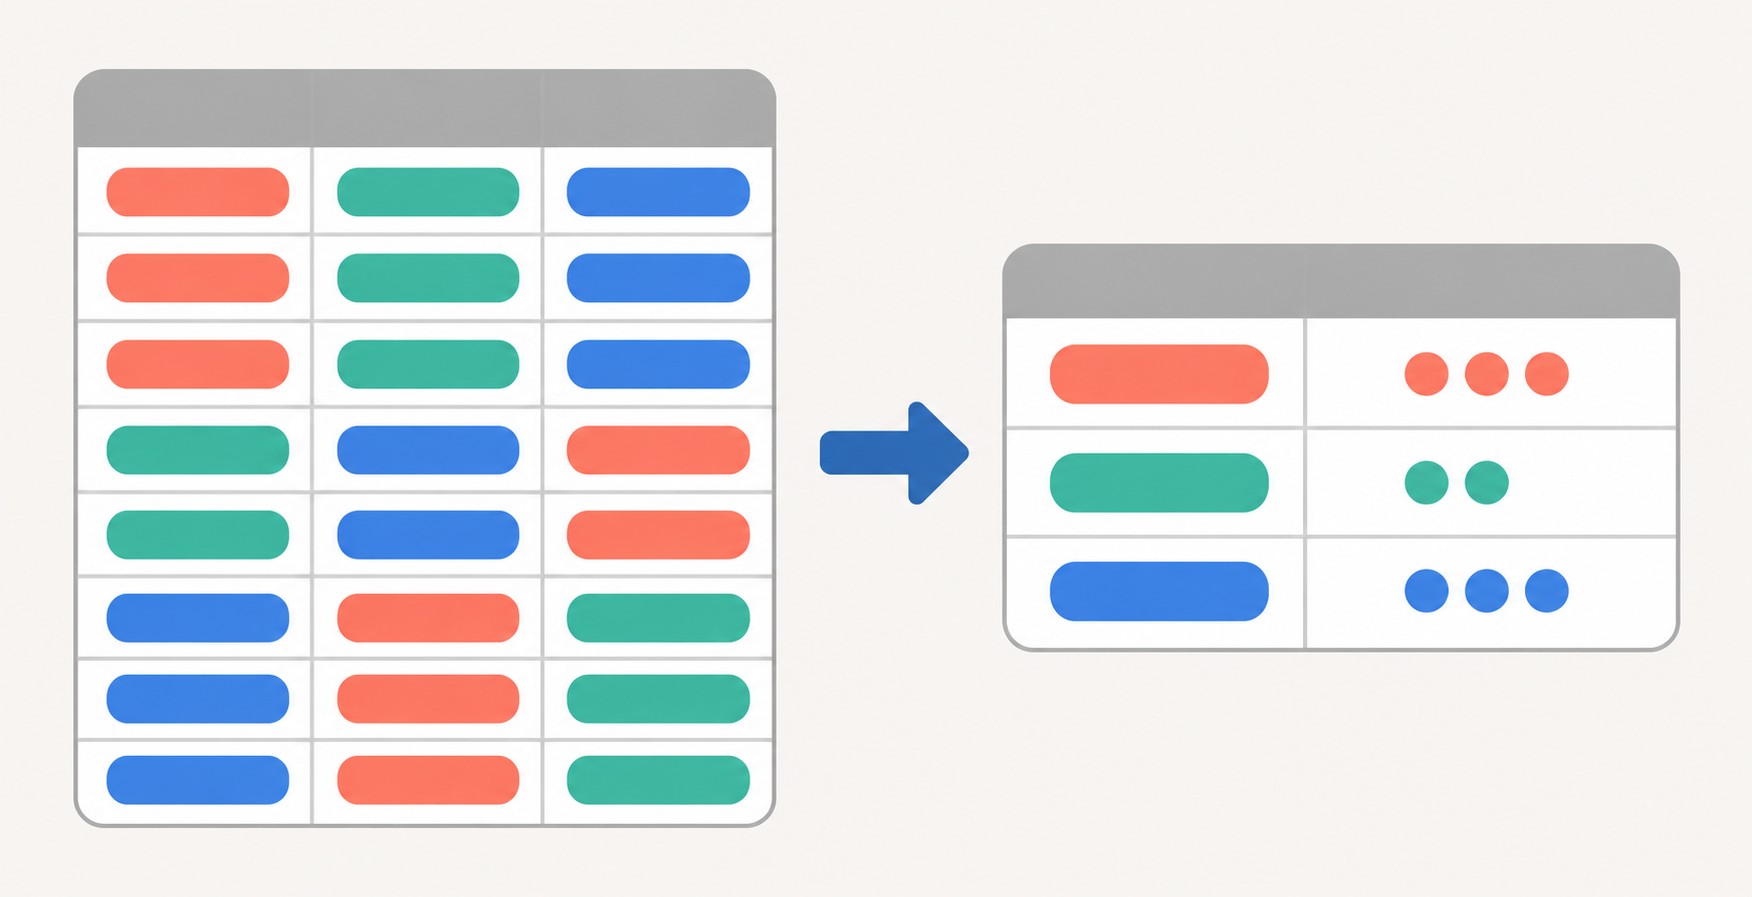
Движок находит все уникальные значения status (NEW, PAID, CANCELED), создаёт по одной группе для каждого и считает агрегаты внутри неё. Результирующий набор — три строки вместо исходных сотни: GROUP BY автоматически убирает дубликаты по ключу группировки.
-- Снипет 7: детализация по статусу и способу оплаты
SELECT
    status,
    payment_method,
    COUNT(*) AS orders_count,
    SUM(amount) AS total_amount
FROM orders_with_status
GROUP BY status, payment_method;
Здесь группа — уникальное сочетание значений status и payment_method. Результат: пять строк — (NEW, CARD), (NEW, CASH), (PAID, CARD), (PAID, CASH), (CANCELED, CARD). Второй столбец добавляют, когда нужна детализация внутри категории.
Когда в данных есть повторяющиеся значения, COUNT(*) завышает реальное число уникальных событий:
-- Снипет 8: общие заказы vs уникальные дни по статусу
SELECT
    status,
    COUNT(*)                   AS orders_total,
    COUNT(DISTINCT order_date) AS unique_days
FROM orders_with_status
GROUP BY status;
Если для статуса NEW три заказа сделаны в два дня: orders_total = 3, unique_days = 2. COUNT(DISTINCT) считает уникальные ненулевые значения внутри каждой группы.
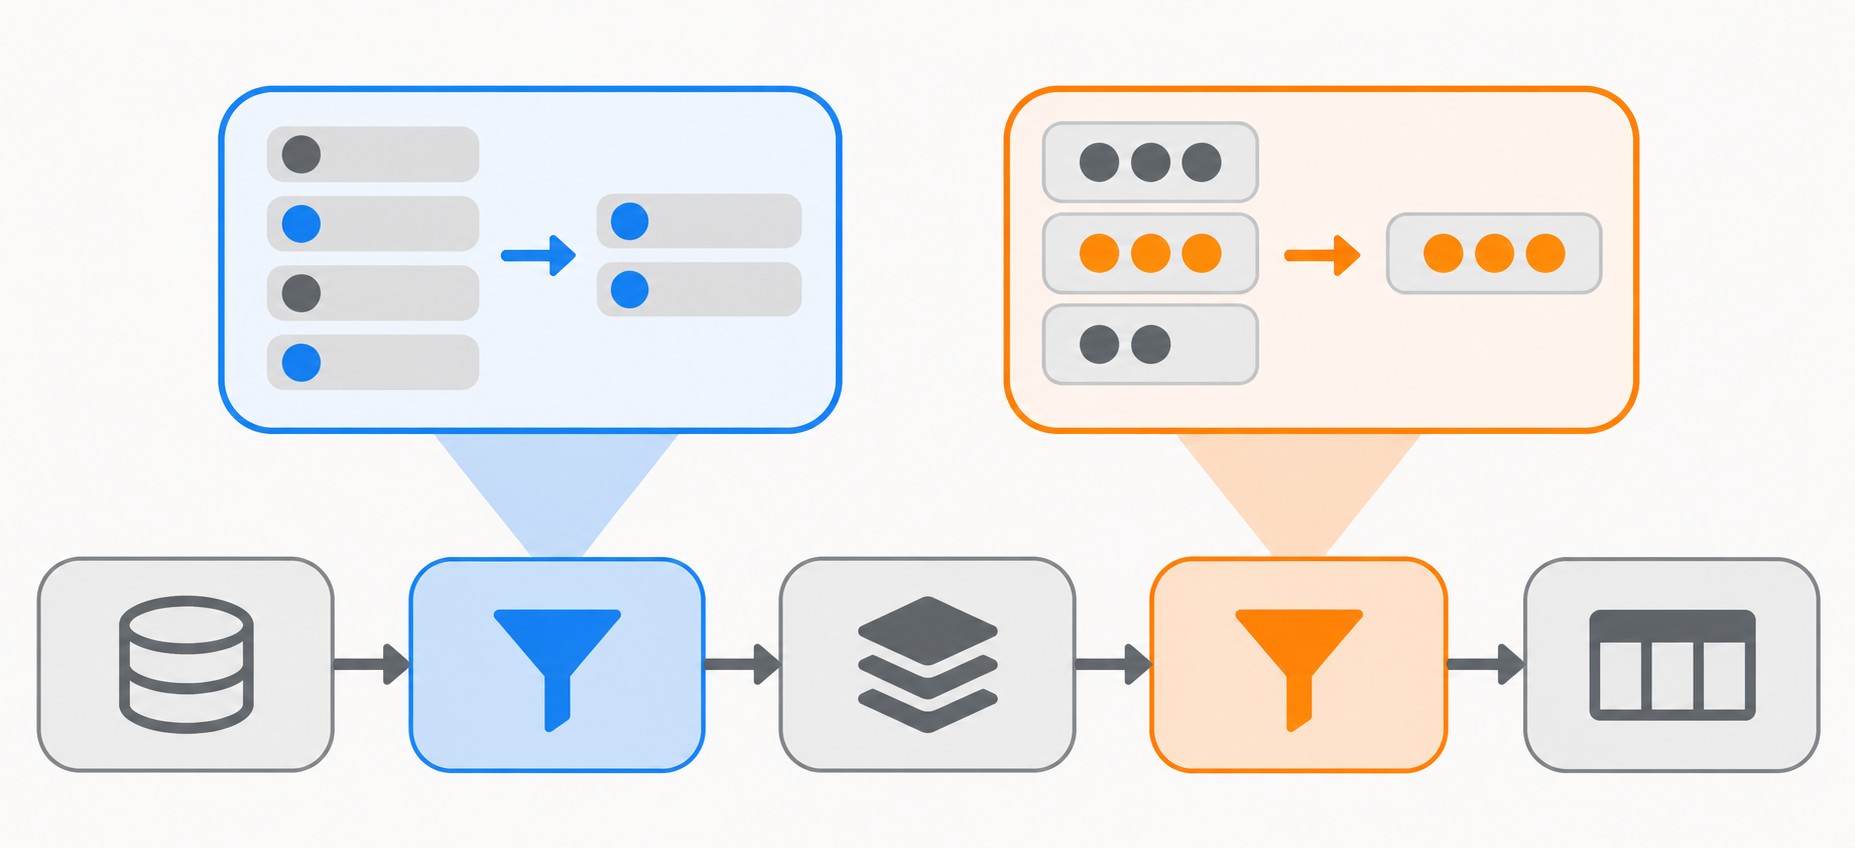
Есть два способа фильтрации при группировке — и они не взаимозаменяемы. WHERE отбирает строки до того, как формируются группы. HAVING отсеивает готовые группы по результату агрегации. Перепутать их — одна из самых распространённых ошибок при работе с GROUP BY в SQL.
Хотите сменить профессию или повысить квалификацию?
Федеральный проект «Активные меры содействия занятости» даёт возможность пройти обучение бесплатно за счёт государства
-- Снипет 9: заказы по статусу только за февраль 2026
SELECT
    status,
    COUNT(*) AS orders_count
FROM orders_with_status
WHERE order_date >= '2026-02-01'
  AND order_date < '2026-03-01'
GROUP BY status;
WHERE обрабатывается на втором шаге пайплайна: в группировку попадут только строки за февраль. Агрегатные функции здесь недопустимы — группы ещё не образованы.
-- Снипет 10: статусы с двумя и более заказами
SELECT
    status,
    COUNT(*) AS orders_count
FROM orders_with_status
GROUP BY status
HAVING COUNT(*) >= 2;
HAVING применяется к уже посчитанным группам — четвёртый шаг пайплайна. Если статус CANCELED встречается один раз, в результат он не попадёт. Агрегатные функции в HAVING работают именно потому, что группировка уже выполнена.
-- Снипет 11: февраль 2026, только статусы с ≥ 2 заказами
SELECT
    status,
    COUNT(*) AS orders_count,
    SUM(amount) AS total_amount
FROM orders_with_status
WHERE order_date >= '2026-02-01'
  AND order_date < '2026-03-01'
GROUP BY status
HAVING COUNT(*) >= 2
ORDER BY total_amount DESC;
Пайплайн одной фразой: WHERE фильтрует строки → GROUP BY образует группы → HAVING отсеивает малочисленные → ORDER BY упорядочивает итог.
Оба предложения связаны с организацией данных, но решают разные задачи на разных шагах пайплайна.
| Критерий |
GROUP BY |
ORDER BY |
|---|---|---|
| Задача | создать группы и рассчитать агрегаты | отсортировать итоговый набор строк |
| Позиция в pipeline | шаг 3 | шаг 6 (последний) |
| Влияет на | количество и состав строк результата | порядок вывода строк |
| Требует агрегаты | нет (но обычно используется с ними) | нет |
| Гарантирует порядок | нет | да |
-- Снипет 12: без ORDER BY — порядок строк непредсказуем
SELECT status, COUNT(*) AS cnt
FROM orders_with_status
GROUP BY status;
-- Снипет 13: с ORDER BY — чёткий порядок по сумме
SELECT status, COUNT(*) AS cnt, SUM(amount) AS total_amount
FROM orders_with_status
GROUP BY status
ORDER BY total_amount DESC;
Если в результате встречаются строки с NULL в сортируемом столбце, ORDER BY по умолчанию выводит их первыми при сортировке по возрастанию. Явный контроль: ORDER BY (total_amount IS NULL), total_amount DESC помещает NULL в конец.
GROUP BY создаёт группы, ORDER BY упорядочивает готовый результат — разные шаги, разные задачи, и оба можно использовать в одном запросе.
T-SQL (SQL Server, Azure SQL, Synapse Analytics) расширяет стандартный GROUP BY тремя операторами для многомерного анализа и сводных отчётов.
| Оператор |
Что создаёт |
Количество групп |
Применение |
|---|---|---|---|
| ROLLUP(col1, col2) | иерархические итоги | n+1 уровней | отчёты с промежуточными итогами |
| CUBE(col1, col2) | все 2^n комбинаций | 2^n + grand total | многомерный анализ (OLAP) |
| GROUPING SETS(…) | точные наборы группировки | задаётся явно | несколько GROUP BY за один проход |
GROUP BY () — пустой набор группировки — возвращает гранд-тотал всей таблицы. Пример: GROUPING SETS(Region, ()) даст итоги покаждому региону и одну строку grand total.
-- Снипет 14: продажи по регионам с промежуточными итогами
SELECT Region, Territory, SUM(Sales) AS total_sales
FROM SalesData
GROUP BY ROLLUP(Region, Territory);
Результат включает: (Canada, Alberta), (Canada, BC), (Canada, NULL — итог по Canada), (NULL, NULL — grand total). ROLLUP движется справа налево: сначала детальные группы, потом итоги верхнего уровня. Порядок столбцов влияет на результат. Устаревший синтаксис GROUP BY col WITH ROLLUP сохранён для обратной совместимости — не используйте его в новых разработках.
CUBE(col1, col2) создаёт все четыре комбинации: (col1, col2), (col1, NULL), (NULL, col2), (NULL, NULL). Используется для OLAP-анализа, когда нужны срезы по каждому измерению.
GROUPING SETS((col1), (col2), ()) — точный контроль: вы задаёте конкретные наборы группировки и получаете только их. Это эквивалент UNION ALL нескольких GROUP BY, но за один проход — производительнее.
GROUP BY ALL без столбцов доступен только в Microsoft Fabric Data Warehouse: он автоматически группирует по всем неагрегированным столбцам SELECT. В стандартном SQL Server и Azure SQL Database эта конструкция недоступна.
Три ошибки, с которыми чаще всего сталкиваются при первом знакомстве с группировкой в SQL.
Ошибка 1: неагрегированное поле в SELECT вне GROUP BY
-- ❌ Неправильно: city не в GROUP BY и не обёрнута в агрегат
SELECT customer_id, city, COUNT(*) AS cnt
FROM orders
GROUP BY customer_id;
-- ✅ Правильно: добавить в GROUP BY или обернуть в агрегат
SELECT customer_id, MIN(city) AS city, COUNT(*) AS cnt
FROM orders
GROUP BY customer_id;
Ошибка 2: агрегатная функция в WHERE
-- ❌ Неправильно: WHERE выполняется до GROUP BY — агрегаты недопустимы
SELECT status, COUNT(*) AS cnt
FROM orders
WHERE COUNT(*) > 2
GROUP BY status;
-- ✅ Правильно: фильтрация групп — задача HAVING
SELECT status, COUNT(*) AS cnt
FROM orders
GROUP BY status
HAVING COUNT(*) > 2;
Ошибка 3: неожиданный NULL в результате SUM/AVG
-- ❌ Неправильно: если все amount = NULL, результат NULL — ломает отчёт
SELECT customer_id, SUM(amount) AS total
FROM orders
GROUP BY customer_id;
-- ✅ Правильно: COALESCE защищает от NULL в результате
SELECT customer_id, COALESCE(SUM(amount), 0) AS total
FROM orders
GROUP BY customer_id;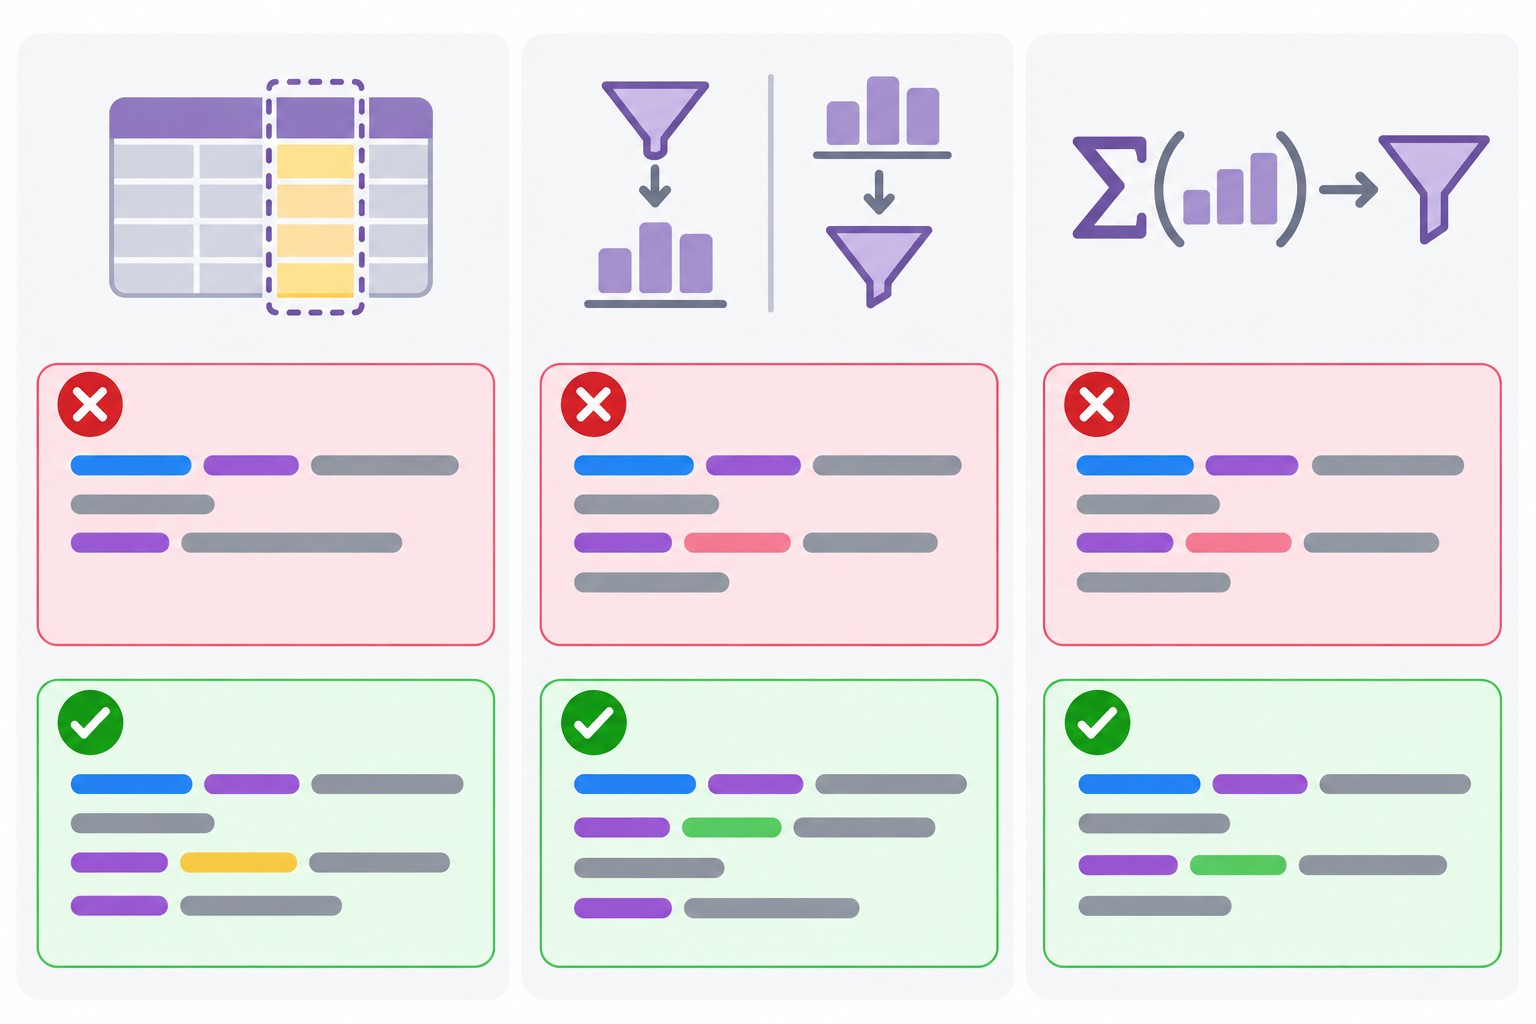
Технически да: GROUP BY без агрегатов работает аналогично DISTINCT и возвращает уникальные сочетания значений. Однако практический смысл GROUP BY — именно в агрегации. Без агрегатных функций в SELECT предпочтительнее DISTINCT: он лаконичнее и точнее отражает намерение запроса.
COUNT(*) считает все строки в группе, включая строки с NULL. COUNT(column) считает только строки, где значение column не равно NULL. Пример: клиент с тремя заказами, один из которых имеет amount = NULL — COUNT(*) = 3, COUNT(amount) = 2. COUNT(DISTINCT column) дополнительно устраняет дубликаты, считая уникальные ненулевые значения.
WHERE выполняется на втором шаге пайплайна — до GROUP BY, когда группы ещё не образованы. Агрегатная функция COUNT(*) не имеет смысла до группировки. Для фильтрации по результату агрегации используйте HAVING: GROUP BY status HAVING COUNT(*) > 2. HAVING выполняется на четвёртом шаге, после расчёта агрегатов.
Нет. GROUP BY не гарантирует порядок строк — он зависит от реализации СУБД и может меняться от запроса к запросу. Для получения отсортированного результата всегда добавляйте ORDER BY: GROUP BY status ORDER BY COUNT(*) DESC. ORDER BY выполняется последним — на шестом шаге пайплайна.
Да. GROUP BY col1, col2 создаёт группы по уникальным сочетаниям значений обоих столбцов. Например, GROUP BY status, payment_method создаст отдельную группу для каждой пары: (NEW, CARD), (NEW, CASH), (PAID, CARD) и так далее. Агрегаты рассчитываются внутри каждой группы независимо.
Все строки с NULL в столбце группировки объединяются в одну группу — SQL считает значения NULL равными. Если в столбце category несколько строк с NULL, они попадут в единую группу, и для неё будут рассчитаны агрегаты. Это не то же самое, что NULL в строках результатов ROLLUP и CUBE.
ROLLUP создаёт иерархические итоги, двигаясь справа налево: для ROLLUP(col1, col2) — итоги по (col1, col2), по (col1) и grand total. CUBE создаёт все 2^n комбинаций: для двух столбцов — (col1, col2), (col1, NULL), (NULL, col2), (NULL, NULL). ROLLUP — для иерархических отчётов, CUBE — для многомерного OLAP-анализа.
В T-SQL существуют две конструкции с одинаковым именем. Первая — устаревший GROUP BY ALL column для SQL Server: включает группы, не прошедшие WHERE, с NULL-агрегатами — не рекомендуется в новых разработках. Вторая — GROUP BY ALL без столбцов, только для Microsoft Fabric: автоматически группирует по всем неагрегированным столбцам SELECT. Разные платформы, разная семантика.
Подайте заявку — забронируйте место в группе
45 000 мест на 2026 год. Бесплатное обучение по федеральному проекту «Активные меры содействия занятости»