Виды нейросетей различаются по архитектуре, типу входных данных и целевой задаче. Пять базовых типов: свёрточные сети (CNN, Convolutional Neural Network) — для изображений и видео, рекуррентные сети (RNN/LSTM) — для последовательных данных, трансформеры — для языка и мультимедиа, генеративно-состязательные сети (GAN, Generative Adversarial Network) — для создания контента, перцептроны и многослойные сети (MLP, Multilayer Perceptron) — для классификации и регрессии. Дополнительно выделяют автоэнкодеры и графовые нейросети (GNN, Graph Neural Network). Универсального типа нейросетей не существует: каждая архитектура оптимальна для своего класса задач. В этой статье разбираем основные виды нейросетей, принципы их работы и конкретные области применения.
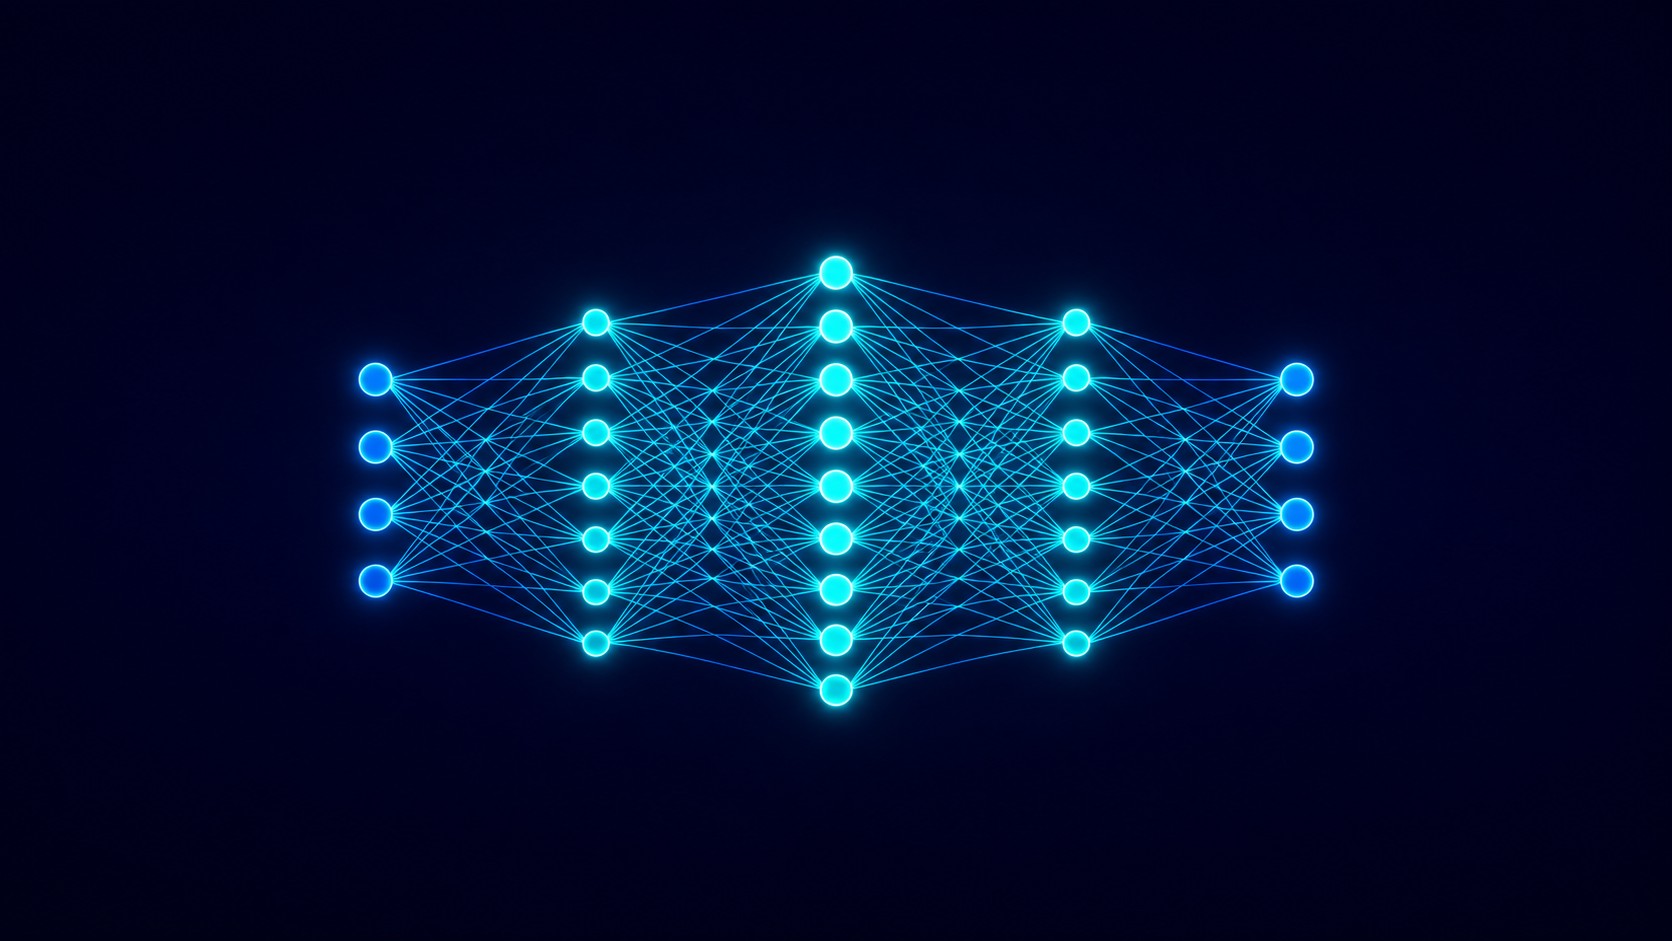
Нейросеть — программная модель, построенная по принципу биологического мозга: искусственные нейроны объединяются в слои и соединяются весовыми связями. При обучении система анализирует входные данные, выявляет закономерности и учится делать предсказания. Концепция появилась в 1943 году, когда Уоррен Маккаллох и Уолтер Питтс описали математическую модель нейрона.
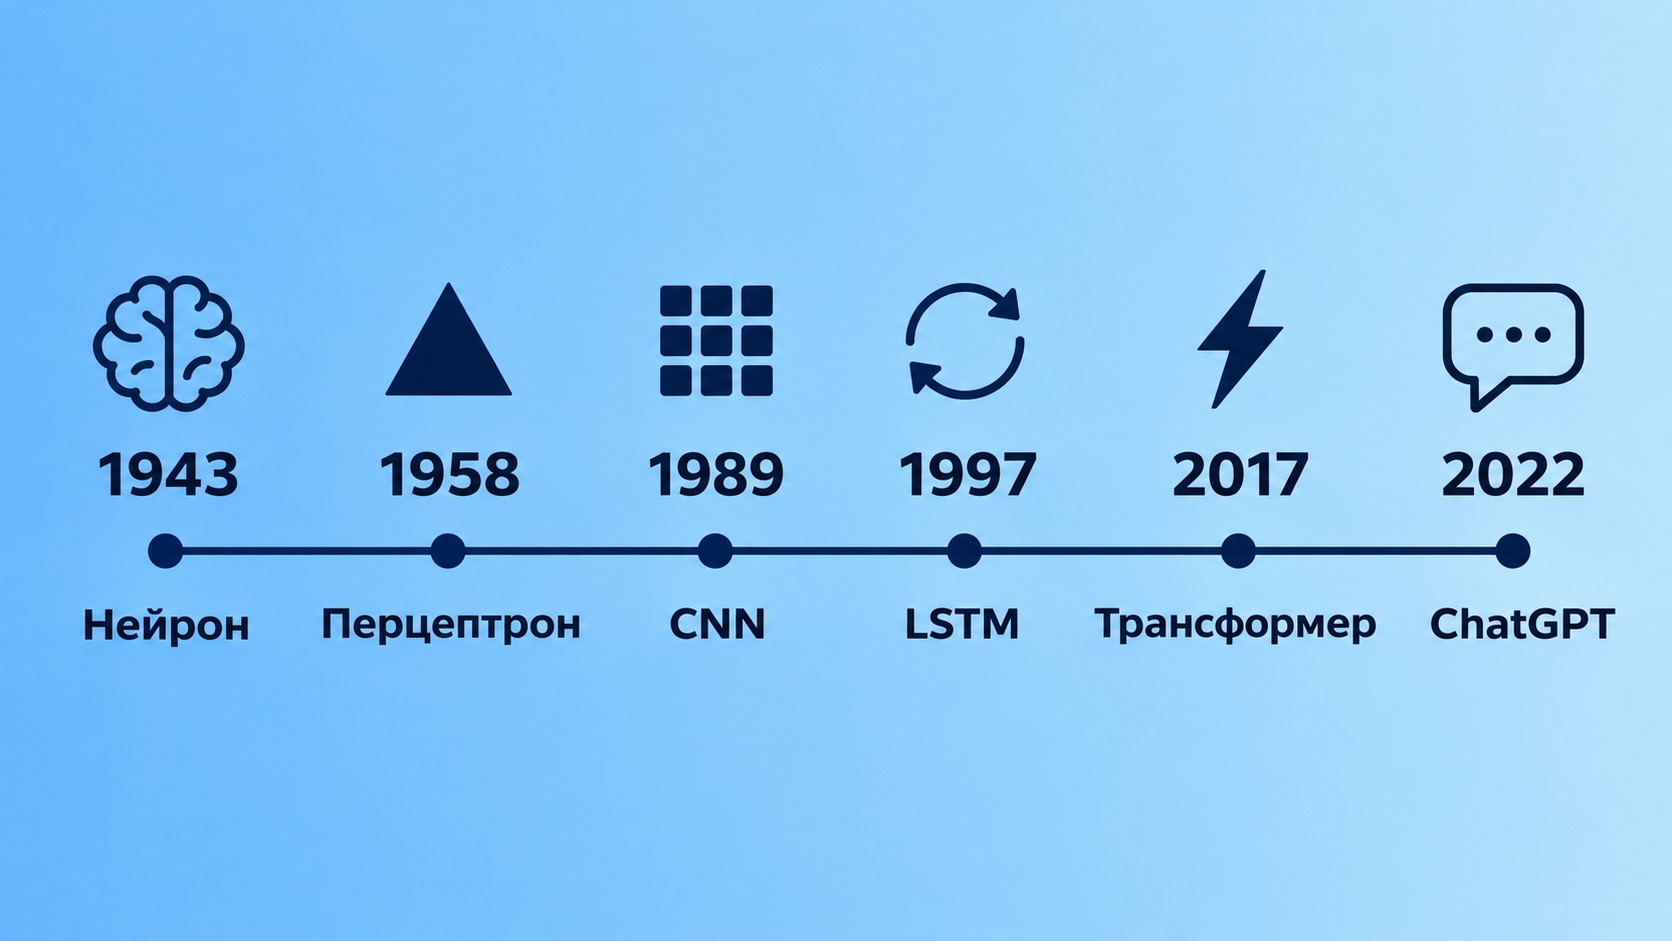
Краткая хронология: 1943 — модель нейрона; 1958 — перцептрон Розенблатта; 1989 — свёрточные сети Яна ЛеКуна; 1997 — LSTM Хохрайтера и Шмидхубера; 2017 — трансформерная архитектура Google; 2022 — ChatGPT выводит нейросети в массовый обиход. С 2022 года число практических применений выросло в разы: нейросети используют для генерации текста и изображений, машинного перевода, распознавания речи и медицинской диагностики. Ключевые факторы роста — доступность вычислительных мощностей, открытые наборы данных и зрелость трансформерной архитектуры.
Нейросети классифицируют по трём признакам: архитектуре, типу входных данных и целевой задаче. Один и тот же вид нейросети способен решать несколько задач, но оптимально работает в своей нише. Ниже — сводная таблица основных видов нейросетей с расшифровкой аббревиатур и примерами моделей.
| Тип |
Аббревиатура |
Специализация |
Задачи |
Пример модели |
|---|---|---|---|---|
| Многослойный перцептрон | MLP | Табличные данные | Классификация, регрессия | Полносвязные сети 1980-х |
| Свёрточная нейросеть | CNN | Изображения, видео | Распознавание объектов, медицина | ResNet, EfficientNet |
| Рекуррентная нейросеть | RNN | Текст, аудио, ряды | Перевод, распознавание речи | Vanilla RNN |
| Долгая краткосрочная память | LSTM | Длинные последовательности | Перевод, прогноз финансов | LSTM-сети |
| Трансформер | — | Текст, мультимодальные данные | Генерация текста, вопрос-ответ | GPT-4o, BERT, GigaChat |
| Генеративно-состязательная сеть | GAN | Синтез данных | Генерация изображений | StyleGAN |
| Автоэнкодер | AE | Сжатие, аномалии | Шумоподавление, детекция | VAE |
Нет универсального типа нейросети: выбирайте архитектуру, исходя из характера ваших данных и конкретной задачи.
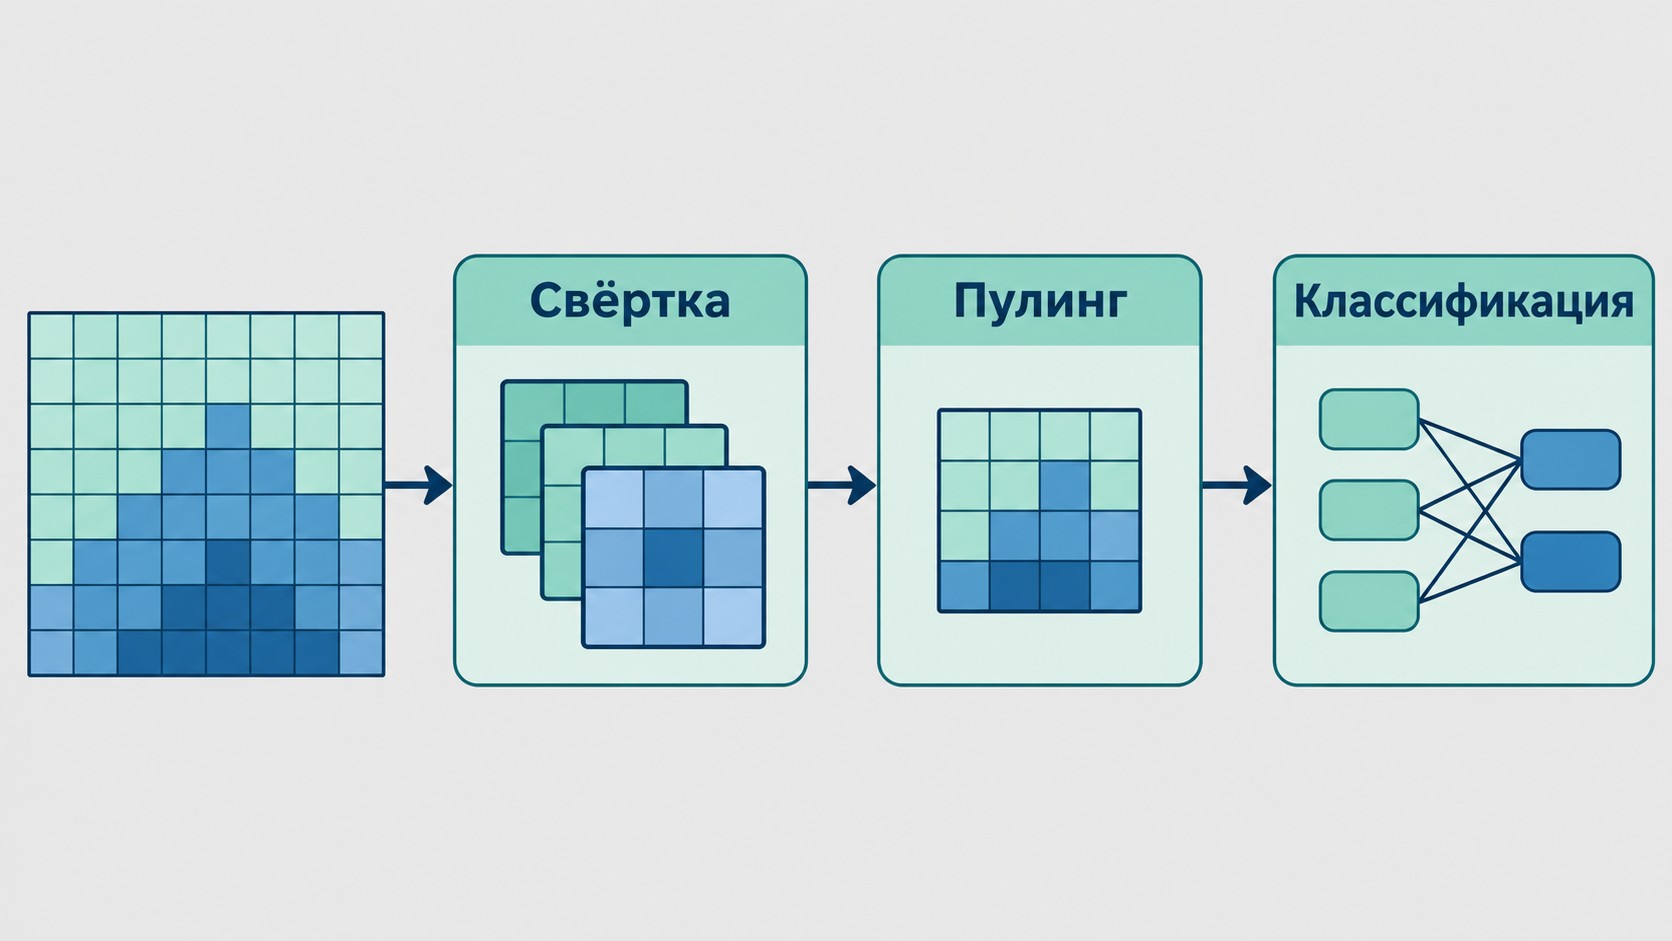
Свёрточная нейросеть — специализированная архитектура для данных с пространственной структурой: изображений, видео, медицинских снимков. Создана в 1989 году Яном ЛеКуном — первой успешно применялась для распознавания рукописных цифр и заложила основу современного компьютерного зрения.
CNN работает в три этапа. Свёрточные фильтры сканируют изображение и извлекают признаки — края, текстуры, формы. Слои пулинга сжимают карты признаков, сохраняя ключевую информацию и снижая вычислительную нагрузку. Плотные слои проводят финальную классификацию. Принцип напоминает зрительное восприятие человека: от общих контуров к деталям.
Области применения: медицина — анализ МРТ и КТ, обнаружение опухолей на ранних стадиях; беспилотный транспорт — распознавание дорожной разметки и пешеходов; системы безопасности — идентификация по лицу; астрофизика — классификация галактик по снимкам телескопов. В отличие от MLP, свёрточная архитектура учитывает пространственные зависимости между пикселями, а не обрабатывает каждый независимо.
Если хотите изучить практическое применение нейросетей — в рамках федерального проекта «Активные меры содействия занятости» доступна программа «Нейросети: работа с системами искусственного интеллекта»: 72 часа, онлайн, от 3 недель. Для участников проекта обучение бесплатно. Смотрите каталог бесплатных программ.
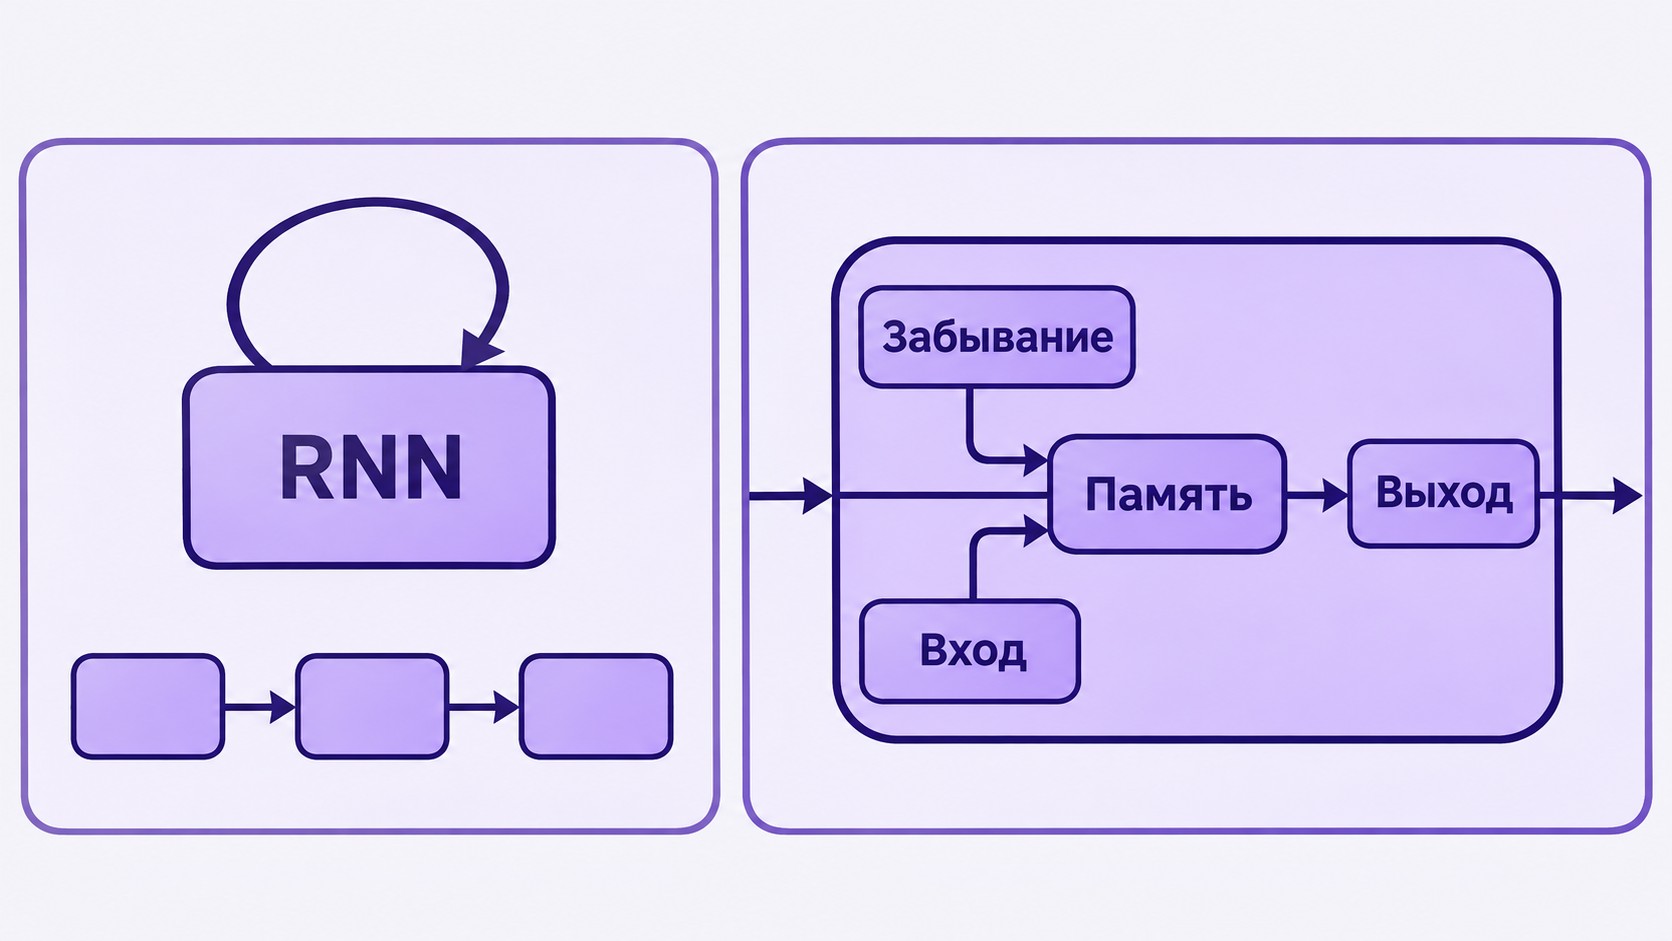
Рекуррентная нейросеть (RNN, Recurrent Neural Network) — архитектура с «памятью»: обратные связи передают информацию от текущего шага к следующему через скрытое состояние. Специализация — последовательные данные, где порядок элементов важен: текст, аудио, временные ряды финансовых котировок.
Классический RNN сталкивается с затуханием градиентов на длинных последовательностях: информация из начала цепочки теряется к концу. Решение — LSTM (Long Short-Term Memory, долгая краткосрочная память), разработанный Хохрайтером и Шмидхубером в 1997 году. LSTM вводит механизм трёх ворот — входных, забывания и выходных, — который избирательно сохраняет и стирает информацию на каждом шаге. Это делает его эффективнее классического RNN при работе с долгосрочными зависимостями.
Применения: машинный перевод, распознавание речи, анализ тональности текста, прогнозирование финансовых рядов. Эволюционная цепочка: RNN → LSTM → трансформер. С 2019 года трансформеры вытеснили LSTM в большинстве задач обработки языка, однако LSTM остаётся актуальным там, где вычислительные ресурсы ограничены.
Трансформер — архитектура на основе механизма самовнимания (self-attention), опубликованная в 2017 году командой Google Brain в статье «Attention Is All You Need». В отличие от RNN, трансформер обрабатывает всю последовательность параллельно: нет затухания градиентов, нет узкого места памяти. Масштаб: от 110 миллионов параметров у BERT-Base до триллиона и более у крупнейших языковых моделей (LLM, Large Language Model — большая языковая модель). Контекстное окно — от 512 токенов до 128 000 и выше.
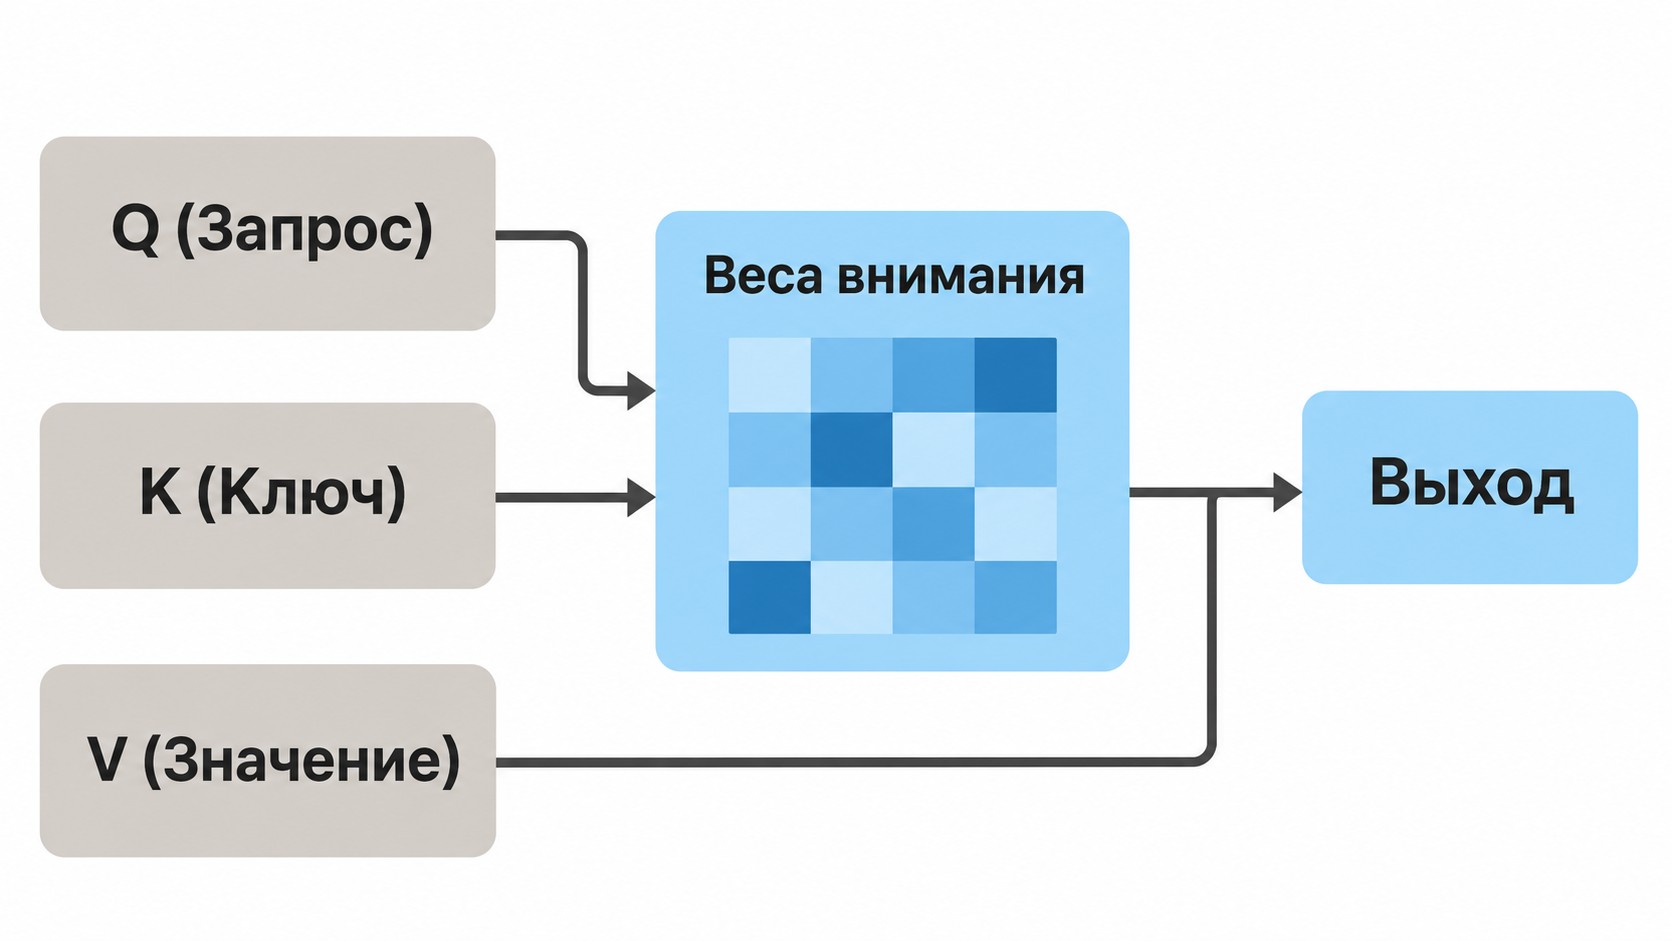
Механизм самовнимания вычисляет вес каждого слова по отношению ко всем остальным словам в последовательности. Три матрицы — запросы (Q), ключи (K) и значения (V) — определяют, какие части входного текста наиболее важны при генерации следующего токена. Именно параллельная обработка делает трансформерную архитектуру эффективнее RNN на длинных текстах и мультимодальных задачах.
Примеры моделей: GPT-4o (OpenAI), BERT и Gemini (Google), YandexGPT 3 (Яндекс), GigaChat (Сбер).
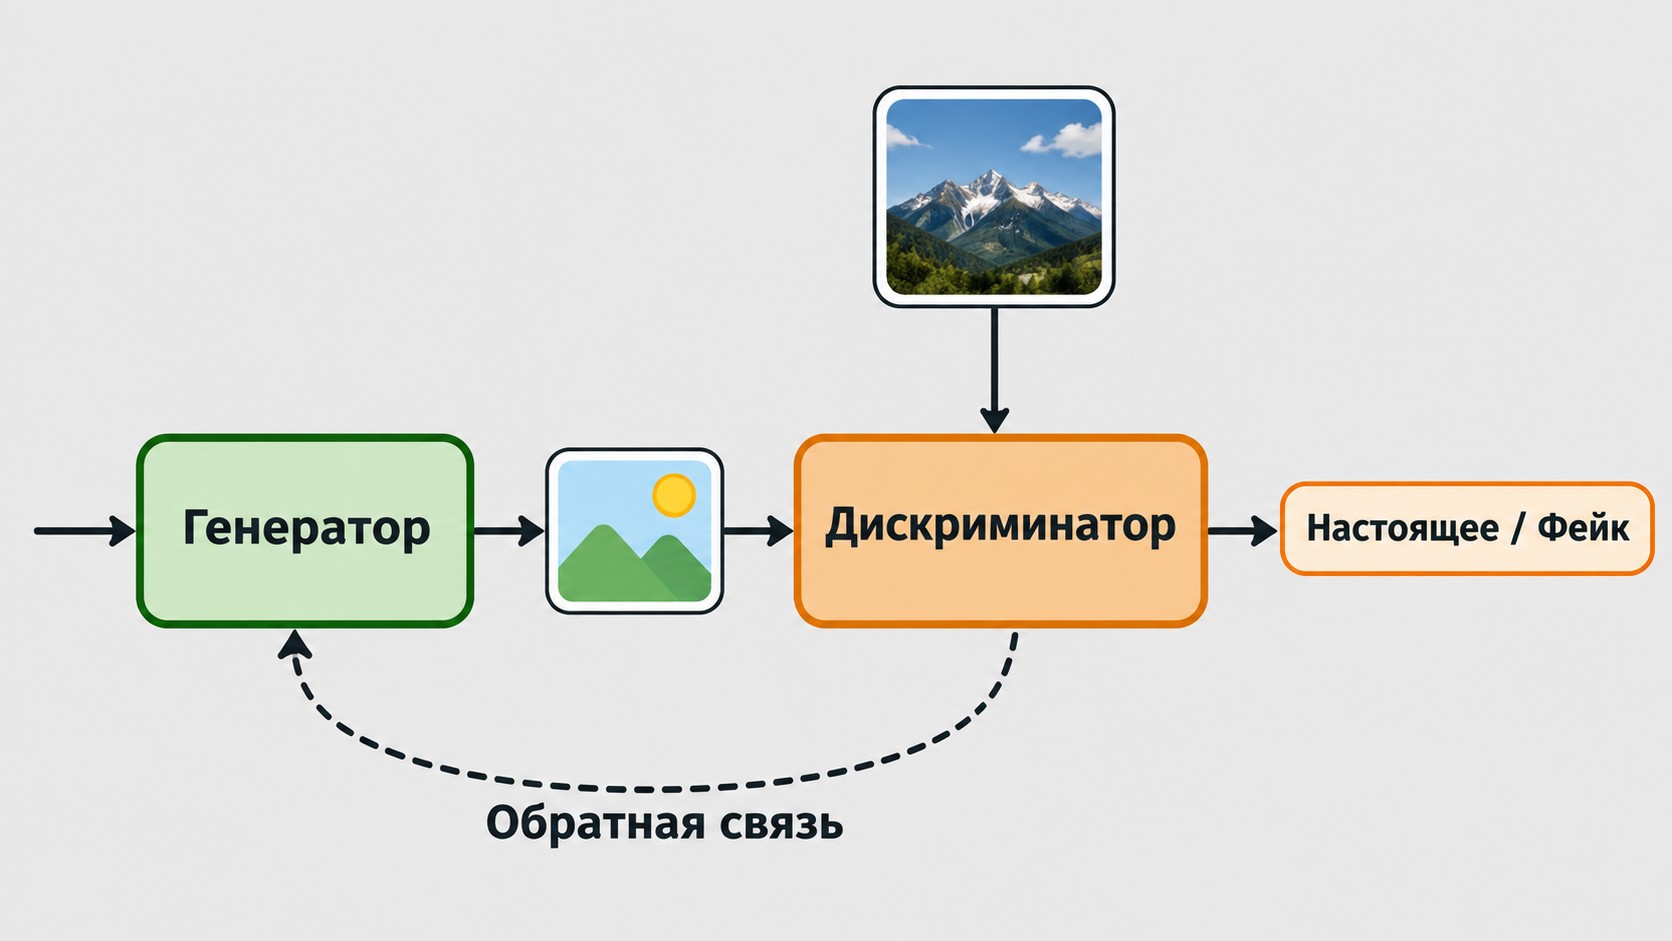
Генеративно-состязательная сеть (GAN, Generative Adversarial Network) создана Яном Гудфеллоу в 2014 году. Архитектура состоит из двух конкурирующих компонентов: генератор синтезирует данные, дискриминатор оценивает их реальность. Итеративное состязание продолжается, пока генератор не научится стабильно обманывать дискриминатор. Слабое место — mode collapse («зацикливание»): генератор может застрять на небольшом наборе образцов.
Применения GAN: синтез реалистичных изображений и видео, реставрация старого кино, создание 3D-моделей, улучшение разрешения медицинских снимков. С 2022 года GAN частично вытесняются диффузионными моделями (Stable Diffusion, DALL-E 3): они демонстрируют более высокое качество и стабильность при генерации изображений.
Хотите сменить профессию или повысить квалификацию?
Федеральный проект «Активные меры содействия занятости» даёт возможность пройти обучение бесплатно за счёт государства
Автоэнкодер сжимает данные до компактного представления и восстанавливает их обратно — применяется в обнаружении аномалий, шумоподавлении и рекомендательных системах. Графовая нейросеть (GNN, Graph Neural Network) работает с данными в форме графов: рекомендательные системы, молекулярная биология, анализ социальных связей.
Архитектура отвечает на вопрос «что такое нейросеть», а парадигма обучения — на вопрос «как она учится». Это два независимых измерения: один и тот же вид нейросети может обучаться по разным парадигмам в зависимости от доступных данных и задачи.
| Вид обучения |
Данные |
Принцип |
Применение |
|---|---|---|---|
| С учителем (Supervised) | Размеченные пары вход–выход | Минимизация ошибки на известных ответах | BERT, классификаторы изображений |
| Без учителя (Unsupervised) | Неразмеченные данные | Выявление скрытых структур и закономерностей | Автоэнкодеры, кластеризация |
| С подкреплением (Reinforcement Learning) | Среда + система наград | Максимизация долгосрочного вознаграждения | AlphaGo (DeepMind), игровые агенты |
Современные языковые модели сочетают несколько парадигм: предобучение на открытых корпусах (без учителя), дообучение на размеченных диалогах (с учителем) и выравнивание через обратную связь от людей — RLHF (Reinforcement Learning from Human Feedback, обучение с подкреплением на основе оценок людей).
Пять базовых типов: свёрточные (CNN) — для изображений и видео, рекуррентные (RNN/LSTM) — для последовательных данных, трансформеры — для языка и мультимедиа, генеративно-состязательные (GAN) — для создания контента, перцептроны и MLP — для классификации. Дополнительно выделяют автоэнкодеры и графовые нейросети (GNN).
CNN специализируется на пространственных данных — изображениях и видео. RNN работает с последовательными данными — текстом, аудио, временными рядами. Под визуальные задачи выбирайте CNN, под речь и текст — RNN или трансформер. Смешивать архитектуры без веских причин нецелесообразно.
LSTM (Long Short-Term Memory, долгая краткосрочная память) — подтип RNN, разработанный в 1997 году. Решает проблему затухания градиентов через механизм ворот забывания, входных и выходных. Применяется для машинного перевода, распознавания речи и прогнозирования временных рядов.
Сеть прямого распространения (feedforward neural network) — архитектура без обратных связей: данные идут строго от входа через скрытые слои к выходу. Классический пример — перцептрон и MLP, основной инструмент для задач классификации и регрессии на табличных данных.
В стандартной классификации видов нейросетей нет «абсолютно универсальной» архитектуры. Каждый тип специализирован: CNN не справляется с временными рядами, RNN плохо масштабируется на очень длинных последовательностях, трансформер требует огромных вычислительных ресурсов.
Генератор создаёт синтетические данные, дискриминатор проверяет их реальность. Состязательный цикл продолжается до устойчивого результата. GAN применяется для синтеза фотографий, реставрации кино и создания 3D-моделей.
Яндекс использует трансформерную архитектуру в YandexGPT 3 и YandexART; Алиса построена на аналогичных принципах. Сбер развивает GigaChat (языковая модель) и Kandinsky (генерация изображений). Все крупные отечественные модели основаны на трансформерной архитектуре.
Галлюцинации — правдоподобные, но ложные ответы. Возникают из-за вероятностных связей: модель «достраивает» паттерн там, где нужных данных нет. Верифицируйте ответы нейросетей в надёжных источниках, особенно в медицине и праве.
Подайте заявку — забронируйте место в группе
45 000 мест на 2026 год. Бесплатное обучение по федеральному проекту «Активные меры содействия занятости»