Каждую минуту пользователи загружают на YouTube 500 часов видео, платёжная сеть Visa обрабатывает 100 000 транзакций, а смартфоны по всему миру отправляют миллиарды GPS-отметок. Если обычные данные — стакан воды, то Big Data — океан без видимых берегов.
Big Data (большие данные) — массивы информации объёмом от 150 ГБ/сутки, которые стандартный Excel или локальная база данных физически не осилят. Для работы с ними нужны специализированные технологии: распределённые вычисления, дата-центры, инструменты вроде Hadoop и Apache Spark.
Термин предложил Клиффорд Линч в спецвыпуске журнала Nature в 2008 году. К 2024 году мировой объём данных достиг 149 зеттабайт (Statista, 2024). Более 70% крупных компаний применяют большие данные как часть операционной стратегии — такие данные приводит McKinsey (2026).
В статье разберём, что входит в концепцию 6V, как устроен цикл обработки, где применяются большие данные и какие профессии они порождают.
Big Data — технологическая концепция: сбор, хранение и анализ данных объёмом от 150 ГБ/сутки с помощью специализированных инструментов. Это не просто «много файлов», а информация, которую невозможно обработать стандартными средствами за разумное время.
Три сценария, где большие данные делают то, что Excel не решит никогда:
| Критерий |
Традиционные данные |
Big Data |
|---|---|---|
| Объём | Гигабайты | Терабайты, петабайты и выше |
| Скорость обновления | Периодически (пакетно) | Реальное время или near-real-time |
| Формат | Однородный (таблицы) | Разнородный: текст, видео, IoT, GPS |
| Инфраструктура | Локальная СУБД, Excel | Распределённые кластеры, облако |
| Инструменты | SQL, Excel | Hadoop, Spark, Kafka, NoSQL |
| Специалисты | Аналитик, DBA | Data Engineer, Data Scientist |
| Пример | Таблица сотрудников | Все транзакции Visa за 1 секунду |
Термин «Big Data» появился в спецвыпуске журнала Nature в 2008 году — Клиффорд Линч предложил его для обозначения массивов, превышающих 150 ГБ/сутки и требующих нестандартных инструментов обработки.
К 2012 году объём данных вырос настолько, что компании начали системно внедрять новые инструменты работы с ними. В 2014-м ведущие университеты включили Big Data в учебные программы IT-специальностей. По данным McKinsey (2026), сегодня более 70% крупных организаций применяют большие данные как часть стратегии. Мировой объём данных в 2024 году — 149 зеттабайт (Statista, 2024).
Первую модель — 3V — предложила исследовательская компания META Group в 1990-х: Volume (объём), Velocity (скорость), Variety (разнообразие). Позже добавили Veracity (достоверность) и Value (ценность), а современная расширенная версия включила Variability (изменчивость). Сегодня отраслевым стандартом считается модель 6V.
Каждый признак описывает отдельное измерение проблемы: мало просто собрать данные — важно, чтобы они поступали вовремя, были надёжны, разнородны по типу и приносили реальную пользу.
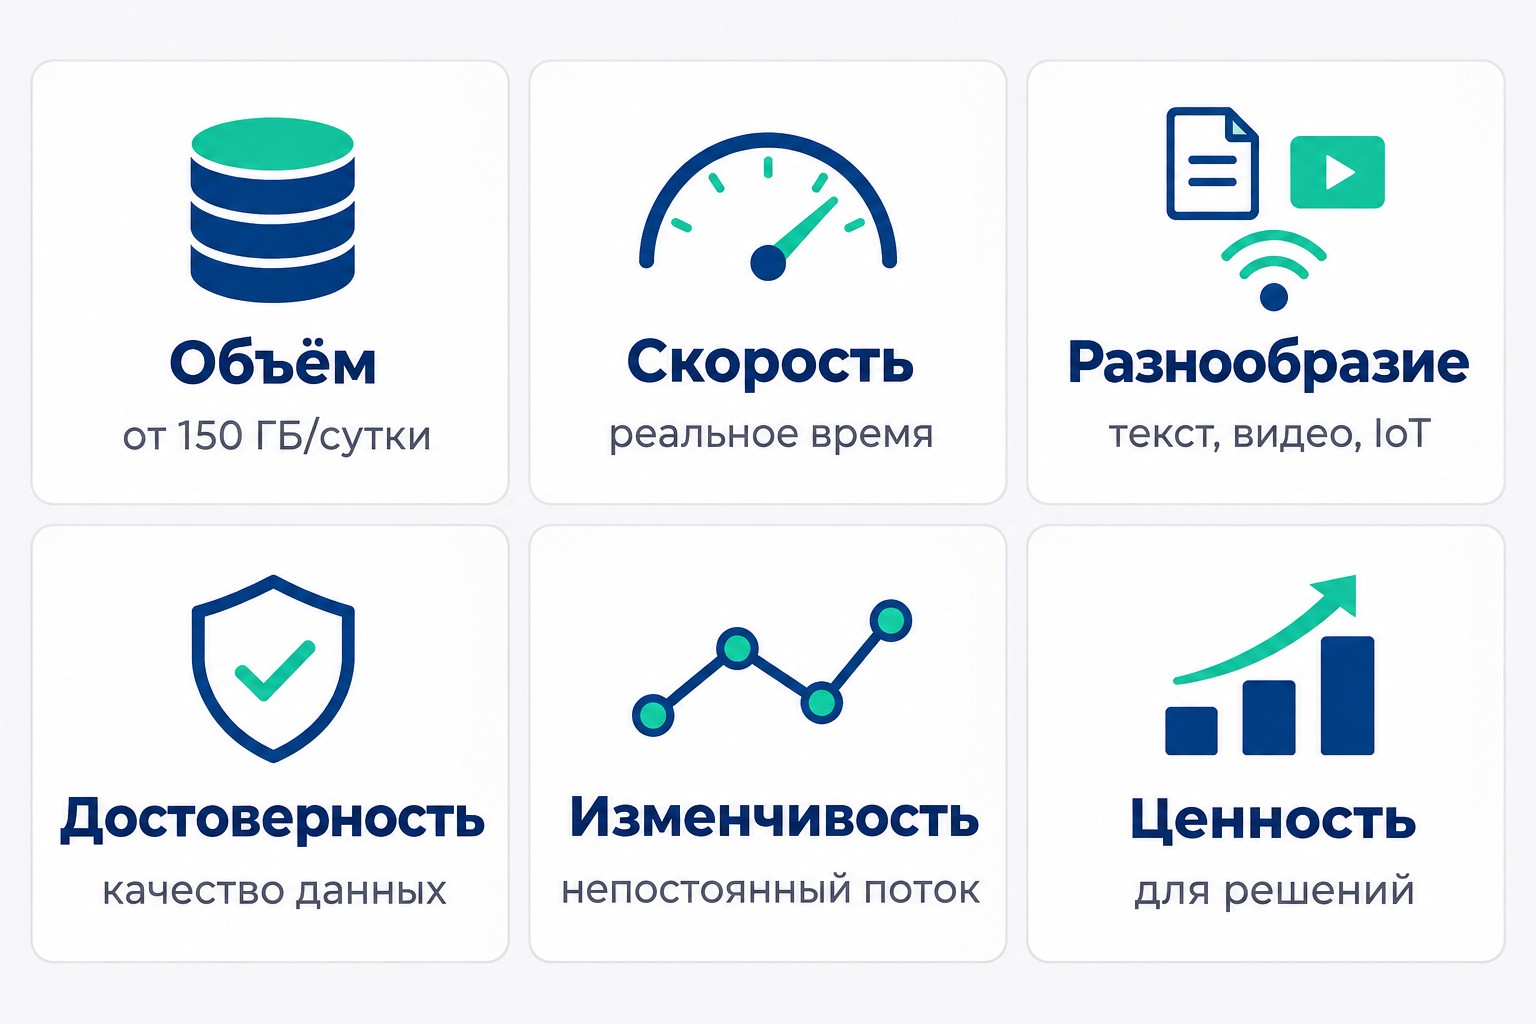
Volume (Объём) — исходный признак концепции. Порог — 150 ГБ/сутки, но реальные системы оперируют терабайтами и петабайтами. Только пользователи YouTube ежеминутно загружают 500 часов видео. По данным Statista (2024), мировой объём данных в 2024 году составил 149 зеттабайт.
Velocity (Скорость) — с какой быстротой данные поступают и должны быть обработаны. Платёжная сеть Visa обрабатывает 100 000 транзакций в секунду: каждая проверяется на мошенничество немедленно, без задержки в очереди.
Variety (Разнообразие) — данные приходят в разных форматах: текст, фото, видео, координаты GPS, показания датчиков IoT. Фитнес-приложение одновременно считывает пульс (число), геолокацию (координаты), аудио тренировки (мультимедиа) и текстовые заметки — наглядный пример разнородного потока из одного источника.
Veracity (Достоверность) — качество данных: если в обучающую модель попадают фейковые отзывы, она даёт ошибочные рекомендации. Поэтому Data Cleaning (очистка данных) — обязательный этап перед любым анализом, а не опция.
Variability (Изменчивость) — интенсивность потока меняется непредсказуемо. В Чёрную пятницу трафик маркетплейсов вырастает в 10–100 раз за час: системы обработки Big Data должны масштабироваться мгновенно, иначе инфраструктура не выдержит пика.
Value (Ценность) — ключевой признак: данные без применения равны нулю. Рекомендательная система Amazon анализирует историю покупок, просмотров и поведения пользователя — и приносит компании дополнительные 35% выручки. Данные становятся активом только тогда, когда из них извлекают решения.
Большие данные делятся на три вида по степени структурированности — и от этого зависит, как с ними работать.
Структурированные данные хранятся в чётких полях с заранее заданной схемой. Медицинская карта пациента — классический пример: температура, артериальное давление, показатели ЭКГ — каждое значение занимает своё место, легко сортируется и фильтруется с помощью SQL.
Частично структурированные данные не вписываются в жёсткую таблицу, но содержат разметку — теги, метаданные. Пример: файлы о стихийных бедствиях из нескольких ведомств — разный формат (XML, JSON, PDF), разные поля, но общая логика записей. Этот вид нередко теряется между двумя крайностями в учебниках.
Неструктурированные данные — самые распространённые: фотографии, музыка, переписка ВКонтакте. Они составляют около 80% всего мирового объёма данных и требуют отдельных алгоритмов обработки — стандартный SQL здесь не поможет.
Разбираться в видах данных — первый шаг для всех, кто планирует работать с Big Data-системами. Если эта тема интересна с карьерной точки зрения, посмотрите программы по анализу данных — они дают полный стек от хранения до прогнозной аналитики.
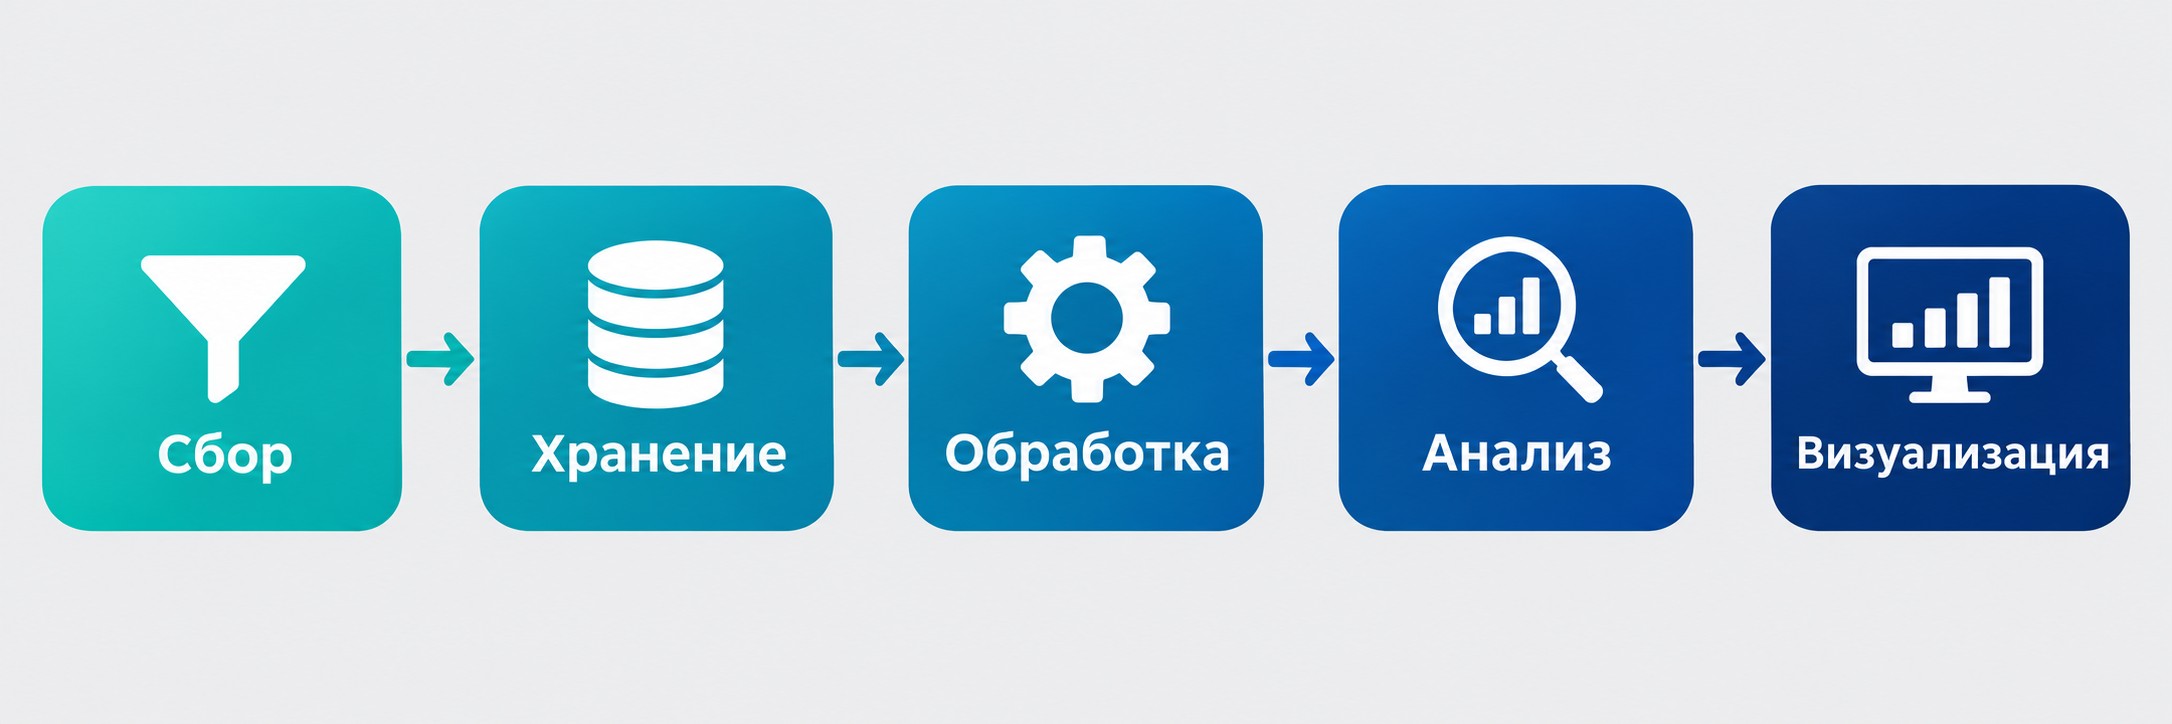
Работа с большими данными — не разовое действие, а непрерывный цикл из пяти последовательных этапов: сбор → хранение → очистка → обработка → анализ и визуализация.
Данные поступают из множества источников одновременно: датчики IoT, банковские транзакции, потоки социальных сетей, GPS-трекеры, веб-логи серверов. Брокер сообщений Apache Kafka принимает миллионы событий в секунду и передаёт их дальше по конвейеру без потерь. На этапе очистки (Data Cleaning) из потока убирают дубли, ошибочные записи и пропуски — иначе «мусор на входе» даёт «мусор на выходе» в любой аналитической модели.
Собранные данные нужно где-то хранить — и выбор хранилища зависит от задачи.
DWH (Data Warehouse, хранилище данных) работает по принципу ETL: Extract (извлечь из источников) → Transform (привести к единой схеме) → Load (загрузить в хранилище). Данные структурированы заранее, SQL-запросы выполняются быстро. Пример: интернет-магазин объединяет таблицы клиентов, транзакций и подразделений в единую аналитическую систему.
Data Lake («озеро данных») хранит всё в сыром виде по принципу ELT: схема применяется при чтении, а не при записи. Аналогия — виртуальный диск без жёсткой папочной структуры: складывают всё подряд, разбираются позже по мере необходимости.
NoSQL-базы (Not Only SQL) — для данных с нестабильной схемой: умный дом, онлайн-игры, рекламные сервисы. Amazon DynamoDB обеспечивает миллисекундный отклик при любой нагрузке. В России Яндекс применяет ClickHouse — колоночную СУБД, лежащую в основе Яндекс Метрики.
MapReduce — парадигма «разделяй и властвуй»: задача делится на подзадачи (Map), которые выполняются параллельно на разных узлах, а результаты объединяются (Reduce). Принцип: отбор → распределение → параллельная обработка → сборка итога.
Hadoop — открытый фреймворк Apache с лицензией Apache 2.0. Реализует MapReduce и хранит данные в файловой системе HDFS. Ключевое преимущество — отказоустойчивость: если один узел выходит из строя, нагрузка автоматически перераспределяется на другие.
Apache Spark — более быстрая альтернатива для задач, где нужна потоковая обработка или машинное обучение. Использует in-memory вычисления: данные обрабатываются в оперативной памяти, а не пишутся на диск на каждом шаге. Поддерживает Python, Scala, R; содержит встроенную библиотеку ML — MLlib.
Big Data Analytics — систематическое извлечение смысла из потоков данных. Четыре метода закрывают разные вопросы: что случилось, почему, что будет и что делать.
Прогнозная аналитика работает на основе машинного обучения: алгоритмы находят паттерны в исторических данных и экстраполируют их на будущее. Data mining (интеллектуальный анализ данных) дополняет картину — он обнаруживает неочевидные закономерности в сырых массивах без заранее сформулированной гипотезы.
| Метод |
Вопрос |
Определение |
Кейс |
|---|---|---|---|
| Описательная | Что произошло? | Анализ прошлых событий по фактическим данным | Google Analytics, статистика продаж X5 |
| Диагностическая | Почему это произошло? | Поиск причин аномалий и отклонений | Amazon: анализ падения дохода по продукту |
| Прогнозная | Что будет? | Machine Learning по историческим паттернам | Кредитный скоринг, прогноз оттока клиентов |
| Предписательная | Что делать? | Автоматизированные рекомендации по действиям | Aurora Health Care: −$6 млн/год, −10% госпитализаций |
Хотите сменить профессию или повысить квалификацию?
Федеральный проект «Активные меры содействия занятости» даёт возможность пройти обучение бесплатно за счёт государства
Большие данные работают в каждой отрасли, где есть высокий объём операций и потребность в прогнозировании.
Финтех. MasterCard анализирует каждую транзакцию в реальном времени и предотвращает мошенничество на $3 млрд в год. Маркетинг и e-commerce. Рекомендательная система Amazon приносит компании 35% выручки — алгоритм подбирает товары на основе поведения миллионов пользователей. Медицина. Big Data позволяет ставить диагнозы на ранних стадиях и прогнозировать вспышки заболеваний. Американская сеть Aurora Health Care снизила уровень госпитализаций на 10% и сэкономила $6 млн в год благодаря предиктивной аналитике. Транспорт и телеком. Навигационные сервисы и FlightRadar24 обрабатывают миллионы GPS-точек в реальном времени; операторы прогнозируют нагрузку на 5G-сеть. Госуправление. Германия вернула €15 млрд неуплаченных налогов через анализ транзакционных данных.
Дополнительные сферы применения: ретейл, HR, IoT-производство, образование, наука.
Экосистема больших данных создаёт устойчивый спрос на специалистов нескольких профилей. Дефицит кадров в области Data Engineering и Data Science сохраняется несколько лет — зарплаты выше среднерыночных уже на старте. Если вы только начинаете путь в данные, освоить базу можно на курсах по аналитике данных с господдержкой.
| Профессия |
Фокус |
Инструменты |
Уровень |
|---|---|---|---|
| Архитектор данных | Проектирование систем хранения | Cloud, SQL, NoSQL, DWH | Senior |
| Data Engineer | Инфраструктура, конвейеры данных | Kafka, Spark, Hadoop | Middle |
| Data Scientist | Прогнозные модели и ML | Python, TensorFlow, Spark | Middle |
| ML-инженер | Внедрение моделей в продакшн | MLflow, Docker, Python | Middle |
| Аналитик данных | Отчёты, дашборды, инсайты | Power BI, Tableau, SQL | Junior |
| DWH-аналитик | Качество хранилища, ETL-процессы | SQL, dbt, Airflow | Junior-Middle |
Big Data и Data Science — смежные, но разные понятия. Их часто путают, потому что специалисты работают на пересечении.
| Big Data |
Data Science |
|
|---|---|---|
| Что это | Технология/инфраструктура | Научная дисциплина |
| Данные | Только массивы от 150 ГБ/сут | Любые данные |
| Фокус | Хранение и обработка | Извлечение ценности |
| Цель | Сделать данные доступными | Найти паттерны и предсказать |
| Специалист | Data Engineer | Data Scientist |
| Инструменты | Hadoop, Spark, Kafka | Python, R, TensorFlow |
Ключевой триплет: Big Data поставляет данные → Data Science извлекает из них ценность. Без инфраструктуры больших данных Data Scientist работает вручную; без аналитических методов Data Science инфраструктура хранит петабайты, не извлекая из них смысла.
В школьной и вузовской информатике big data в информатике изучается как раздел, посвящённый хранению, обработке и анализу сверхбольших массивов. Академическое определение: «огромные массивы информации из различных источников, потенциально представляющие ценность при правильном анализе».
С 2014 года ведущие университеты — MIT, Stanford, Высшая школа экономики — включили тему в программы IT-специальностей: Computer Science, Data Science, прикладная математика. В России дисциплина входит в учебные планы технических вузов как часть курсов по базам данных и распределённым вычислениям.
Это единственный субинтент, который крупные SEO-конкуренты практически не раскрывают: большинство аналитических материалов написаны для бизнеса, а не для студентов и преподавателей.
Чем больше данных собирается, тем острее вопрос: что считается персональными данными и как их можно использовать?
Персональные данные позволяют идентифицировать конкретного человека: имя, адрес, номер телефона, паспортные данные. Обезличенные данные — геолокация без привязки к профилю, агрегированная статистика — формально к персональным не относятся. Парадокс: комбинация обезличенных данных из нескольких источников нередко позволяет деанонимизировать пользователя.
В России ключевой закон — 152-ФЗ «О персональных данных» (редакция 2023 года): устанавливает правила сбора, хранения и обработки данных граждан РФ. В Евросоюзе действует GDPR (с 2018 года): запрещает, в частности, сбор данных о составе семьи и национальной принадлежности без явного согласия. В 2024 году в ЕС вступили в силу AI Act и Data Act; Китай с 2021 года регулирует сферу через PIPL (закон о защите персональных данных).
Что дают большие данные:
Реальные ограничения:
Перспективы: умные города, раннее предупреждение о пандемиях, мониторинг экологических катастроф. Германия вернула €15 млрд неуплаченных налогов через анализ транзакционных данных — один из примеров того, как государство применяет большие данные в управлении.
Проверь себя: 1) Что означает каждое V в модели 6V? 2) Чем DWH отличается от Data Lake? 3) Какую NoSQL-базу использует Amazon для масштабируемых приложений?
Big Data (большие данные) — огромные массивы информации объёмом от 150 ГБ/сутки, которые невозможно обработать на обычном компьютере стандартными инструментами. Для работы нужны специальные технологии: Hadoop, Apache Spark, распределённые дата-центры. Термин предложил Клиффорд Линч в журнале Nature в 2008 году. Характеризуются шестью свойствами — 6V: объём, скорость, разнообразие, достоверность, изменчивость, ценность.
Три ключевых отличия: объём (терабайты/петабайты против гигабайт), скорость (реальное время против периодической обработки) и формат (разнородный против однородного). Для Big Data нужна распределённая инфраструктура — Hadoop, Data Lake, NoSQL. Для обычных данных достаточно Excel или локальной СУБД. Пример разрыва: все транзакции Visa за секунду (100 000) против таблицы сотрудников.
В информатике Big Data — раздел, изучающий хранение, обработку и анализ сверхбольших массивов данных. Академическое определение: огромные массивы информации из разных источников, потенциально представляющие ценность при правильном анализе. С 2014 года ведущие университеты включили тему в программы IT-специальностей. Изучается в рамках Data Science, Computer Science и прикладной математики.
Три вида: структурированные (медкарты с чёткими полями — температура, давление, ЭКГ), частично структурированные (файлы разных форматов — например, записи о стихийных бедствиях из нескольких источников) и неструктурированные (фото, музыка, переписка в соцсетях). Неструктурированные составляют около 80% всего объёма данных в мире.
Ключевые технологии: Hadoop (пакетная обработка, открытый исходный код Apache), Apache Spark (потоковая и пакетная, in-memory, быстрее для итеративных задач), MapReduce (парадигма параллельной обработки), Apache Kafka (сбор потоков в реальном времени). Для хранения — DWH (ETL + SQL), Data Lake (ELT + гибкость), NoSQL-базы: DynamoDB, MongoDB, ClickHouse.
В России действует 152-ФЗ «О персональных данных», устанавливающий правила сбора и хранения данных граждан. В ЕС — GDPR (с 2018), AI Act и Data Act (с 2024). В Китае — PIPL (с 2021). Законы разграничивают персональные данные и обезличенные, определяют правила трансграничной передачи и допустимые цели обработки.
Шесть профессий: Архитектор данных (проектирует систему), Data Engineer (строит инфраструктуру, конвейеры), Data Scientist (создаёт прогнозные модели), ML-инженер (внедряет модели в продакшн), Аналитик данных (строит отчёты и дашборды), DWH-аналитик (обеспечивает качество хранилища). Дефицит кадров в сфере устойчивый — зарплаты выше среднерыночных уже на старте.
Главные отрасли: финтех (MasterCard предотвращает мошенничество на $3 млрд/год), маркетинг (Amazon рекомендации = +35% выручки), медицина (ранняя диагностика, пандемии, Aurora Health Care −$6 млн/год), транспорт (навигаторы, FlightRadar24, 5G-прогнозирование), госуправление (Германия вернула €15 млрд через анализ транзакций), а также ретейл, HR, IoT, образование, наука.
Подайте заявку — забронируйте место в группе
45 000 мест на 2026 год. Бесплатное обучение по федеральному проекту «Активные меры содействия занятости»