NoSQL (сокращение от Not Only SQL) — тип систем управления базами данных (СУБД), которые хранят информацию не в жёстких таблицах со строками и столбцами, а в документах, парах ключ-значение, столбцах или графах. Нереляционные базы данных появились как ответ на задачи, с которыми классический SQL медленно справляется: большие объёмы данных (Big Data), миллиарды одновременных запросов, быстро меняющиеся структуры. Три ключевых принципа NoSQL — горизонтальное масштабирование, гибкая схема Schema-on-Read и модель транзакций BASE вместо ACID. В статье разберём шесть типов нереляционных баз данных, их отличия от SQL, реальные примеры СУБД и критерии выбора.
NoSQL — семейство СУБД с нереляционными моделями хранения данных: JSON-документы, пары ключ-значение, столбцы и графы. Аббревиатура Not Only SQL означает «не только SQL», а не «не SQL вовсе» — это расширение возможностей, а не отказ от реляционной парадигмы.
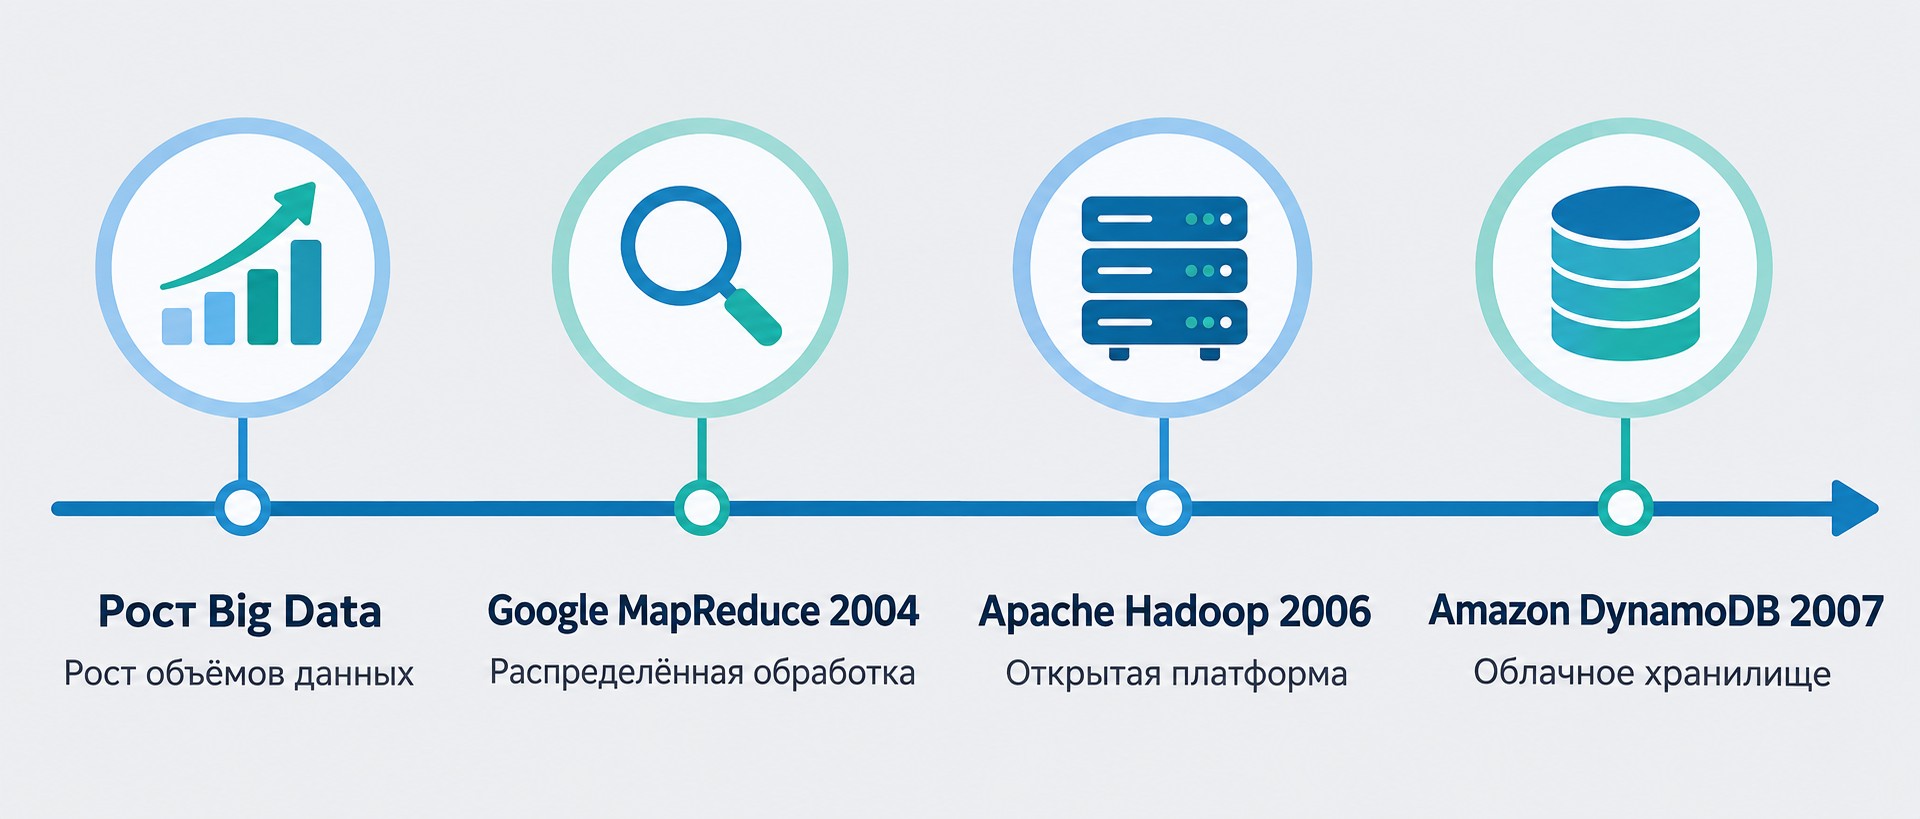
В конце 2000-х реляционные базы данных столкнулись с кризисом масштаба. Взрывной рост социальных сетей, потоки данных от устройств интернета вещей (IoT) и накопление терабайтных Big Data-объёмов требовали решений, которые SQL не мог дать без колоссальных затрат на оборудование. В 2004 году Google опубликовал статью о MapReduce — модели параллельной обработки, ставшей основой Apache Hadoop в 2006 году. Amazon в 2007 году выпустил DynamoDB — первую масштабируемую нереляционную базу для собственной инфраструктуры. Эти события запустили NoSQL-движение: горизонтальное масштабирование оказалось дешевле и гибче, чем наращивание мощности одного сервера.
Выбор между SQL и NoSQL — архитектурная философия, а не просто технический выбор. SQL гарантирует точность и целостность данных. NoSQL отдаёт приоритет скорости и гибкости при больших нагрузках. Четыре ключевых отличия отражены в таблице ниже.
| Параметр |
SQL |
NoSQL |
|---|---|---|
| Масштабирование | Вертикальное (мощнее сервер) | Горизонтальное (больше серверов) |
| Схема данных | Schema-on-Write (жёсткая) | Schema-on-Read (гибкая) |
| Транзакции | ACID | BASE |
| JOIN-запросы | Поддерживаются | Ограничены или отсутствуют |
| Применение | ERP, финансы, аналитика | Big Data, IoT, соцсети, кэш |
| Примеры СУБД | PostgreSQL, MySQL, Oracle | MongoDB, Redis, Cassandra |
Это не конкуренция, а дополнение. Многие современные системы используют обе модели: SQL — для транзакционного ядра, NoSQL — для быстрых операций с высокой нагрузкой.
Транзакционная модель — одно из главных различий между реляционными и нереляционными базами данных.
ACID — стандарт SQL-систем:
Классический пример — банковский перевод: списание с одного счёта и зачисление на другой происходят как единое неделимое действие. При сбое откатываются оба изменения.
BASE — стандарт NoSQL-систем:
BASE сознательно жертвует немедленной согласованностью ради доступности и скорости. Когда вы ставите лайк в социальной сети, другой пользователь увидит его через секунду-другую — это допустимо.
В рамках федерального проекта «Активные меры содействия занятости» доступно обучение по программе «Специалист по аналитике и базам данных в информационных системах» — 72 часа, бесплатно за счёт государства.
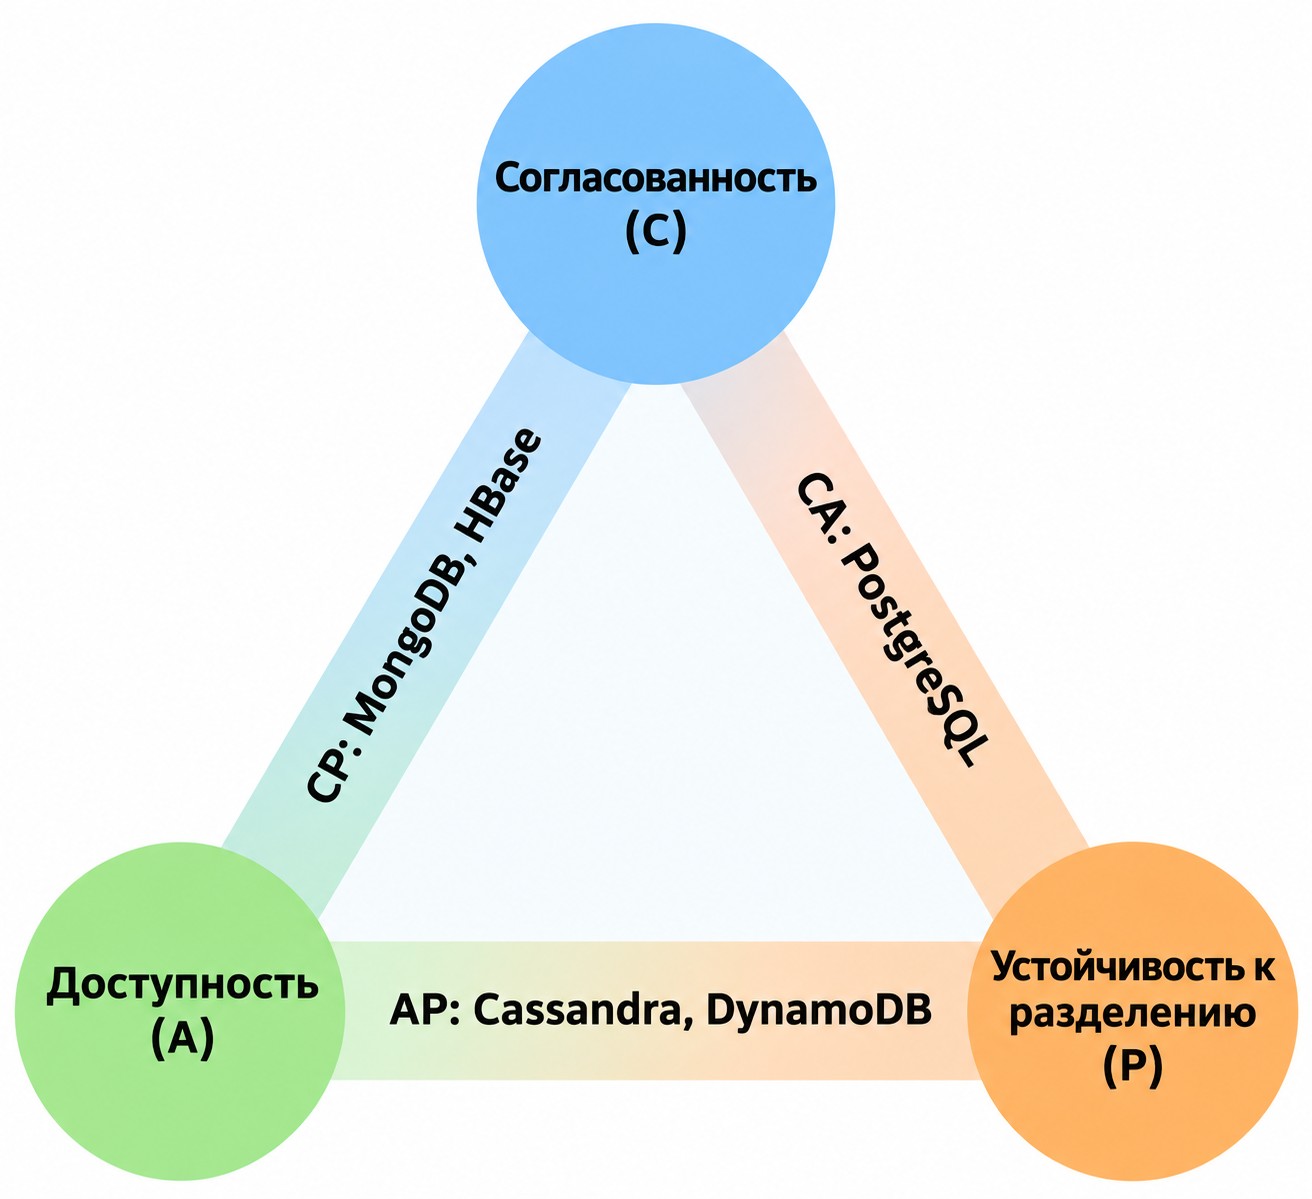
Теорему CAP сформулировал Эрик Брюэр в 2000 году. Она утверждает: распределённая система не может одновременно гарантировать все три свойства.
Поскольку разделение сети (P) неизбежно в реальных распределённых системах, конкретный выбор — между CP и AP. MongoDB и HBase выбирают CP: строгая согласованность данных ценой возможной недоступности при сетевом сбое. Apache Cassandra и CouchDB выбирают AP: система всегда отвечает, но данные на разных узлах могут временно расходиться — это и есть конечная согласованность.
NoSQL — не одна технология, а шесть семейств СУБД. Каждое оптимизировано под конкретный паттерн работы с данными и тип нагрузки. Выбор типа нереляционной базы данных определяет архитектуру всей системы.
| Тип |
Скорость чтения |
Гибкость схемы |
СУБД |
Применение |
|---|---|---|---|---|
| Key-Value | Максимальная | Высокая | Redis, DynamoDB | Кэш, сессии |
| Документная | Высокая | Очень высокая | MongoDB | CMS, профили |
| Столбцовая | Максимальная | Средняя | ClickHouse, Cassandra | OLAP, IoT |
| Графовая | Высокая | Высокая | Neo4j | Соцсети, рекомендации |
| Поисковая | Высокая | Высокая | Elasticsearch | Полнотекстовый поиск |
| In-Memory | Максимальная | Высокая | Redis, Memcached | Real-time, биржа |
Принцип прост: каждое значение (строка, число, JSON или бинарные данные) хранится под уникальным ключом — как в камере хранения с номерными ячейками. Поиск занимает константное время: система обращается напрямую, не перебирая записи. Это делает Key-Value Store самым быстрым типом нереляционных баз данных.
Redis — открытый (Opensource) лидер этого семейства. Данные хранятся в оперативной памяти (RAM), основные команды: SET (записать), GET (прочитать), DEL (удалить), INCR (инкремент счётчика). Субмиллисекундный доступ — норма для Redis. Amazon DynamoDB решает похожие задачи в облаке с автоматической репликацией. Применение: кэширование страниц и запросов, сессии пользователей, корзины покупок, таблицы лидеров онлайн-игр.
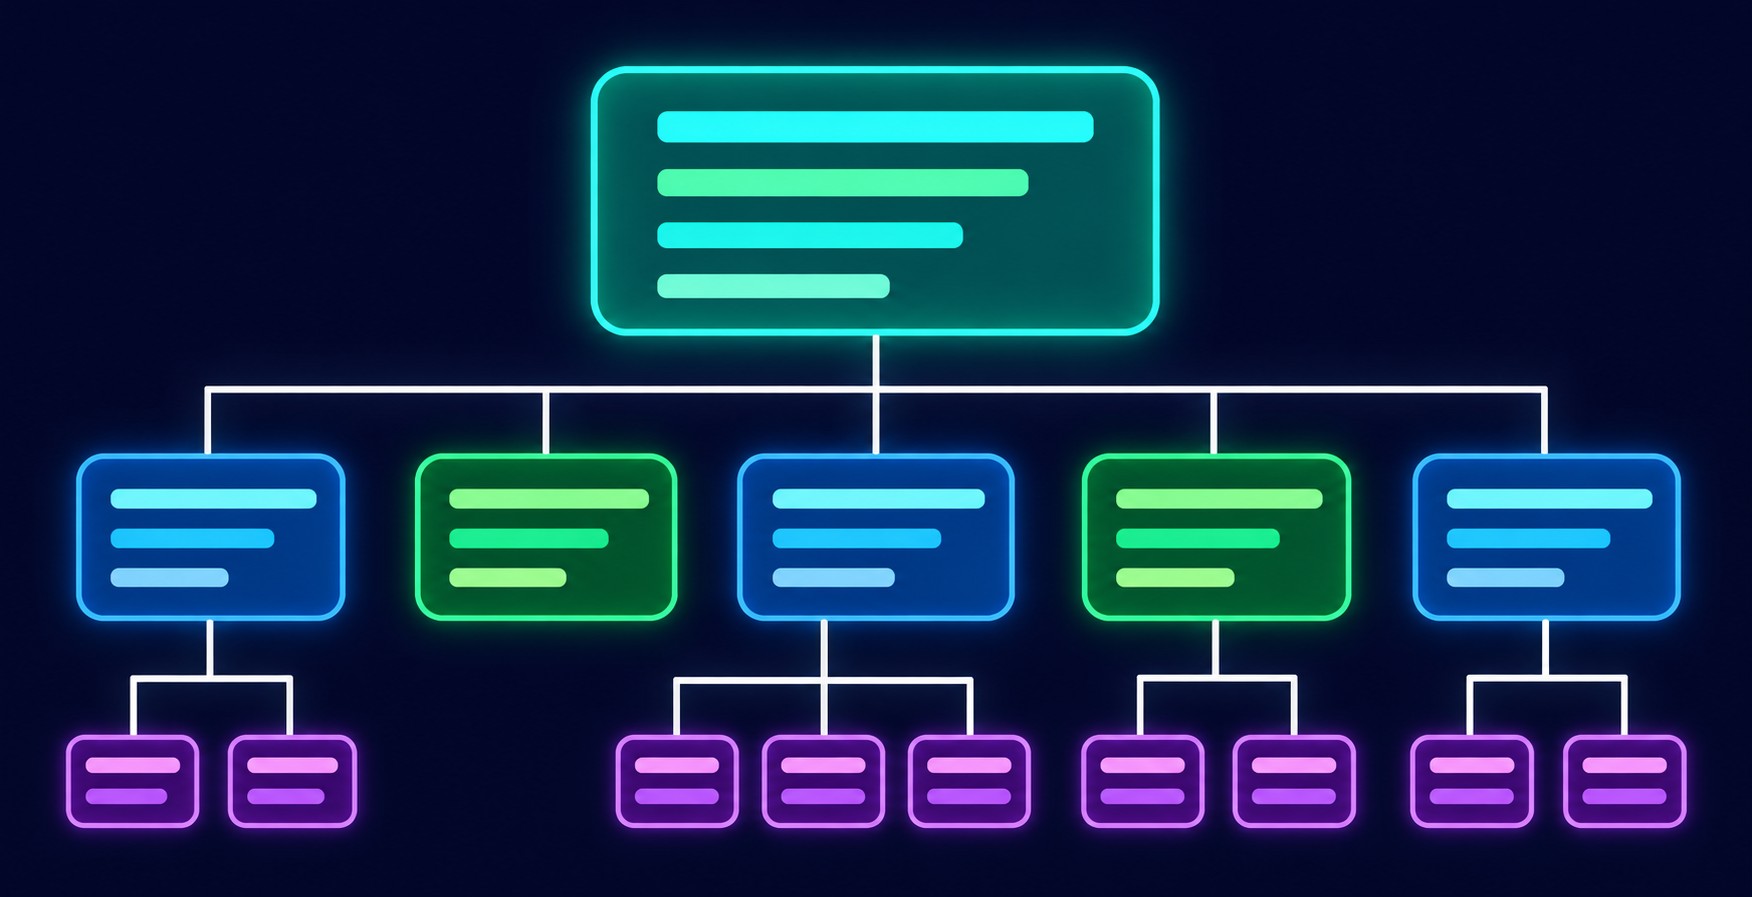
Документная база хранит данные в виде иерархических документов — JSON, BSON (бинарный JSON) или XML. Документ — самостоятельная единица с вложенными структурами: объект «пользователь» может содержать список заказов прямо внутри себя, без отдельной таблицы.
MongoDB — самая распространённая документная база. Работает с форматом BSON, основные команды оболочки: insertOne, find, updateOne, deleteOne. Коллекции в MongoDB аналогичны таблицам в SQL, но каждый документ внутри коллекции может иметь произвольную структуру. Применение: системы управления контентом (CMS), каталоги товаров, профили пользователей, веб-приложения с часто меняющейся моделью данных.
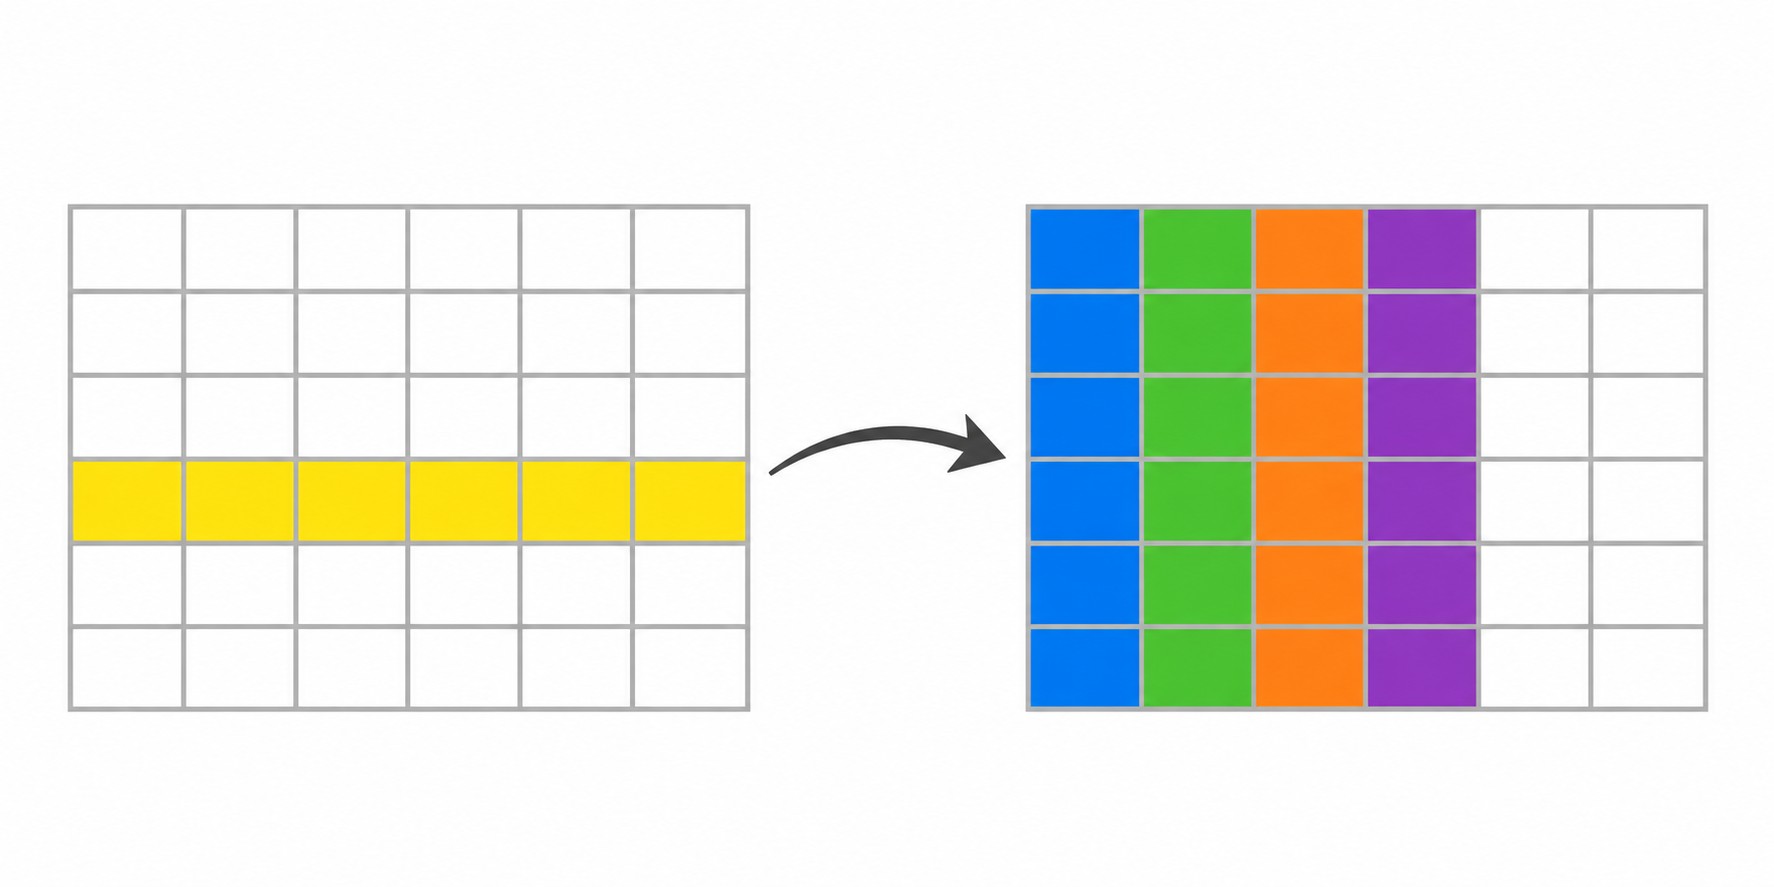
В реляционной базе строка — единица хранения. В столбцовой базе данных данные группируются по столбцам: все значения одного поля хранятся рядом. Это позволяет читать один параметр из миллиарда записей без загрузки всей строки целиком.
Два ключевых принципа столбцовых баз: WORM (Write Once, Read Many — однократная запись, многократное чтение) обеспечивает неизменяемость данных для аудита и логов; MPP (массово-параллельная обработка, Massively Parallel Processing) распределяет запрос между сотнями узлов одновременно. ClickHouse, созданный в Яндексе, — Opensource OLAP-движок (аналитическая обработка запросов, Online Analytical Processing) с открытым исходным кодом, обрабатывающий миллиарды строк за секунды. Apache Cassandra, разработанная в Facebook в 2008 году, — AP-система по теореме CAP с высокой скоростью записи для IoT и событийных потоков.
В реляционной базе связи вычисляются через JOIN при каждом запросе. В графовой базе узлы (сущности) и рёбра (связи) хранятся физически — обход связи занимает O(1), то есть одну операцию независимо от размера графа.
Neo4j — открытый лидер графовых баз с языком запросов Cypher. Узлы содержат свойства (например, имя пользователя), рёбра — атрибуты отношений (например, «дружит с» или «купил»). Применение: социальные сети и граф друзей, рекомендательные системы, системы выявления мошенничества (антифрод) — везде, где важна именно структура связей между объектами.
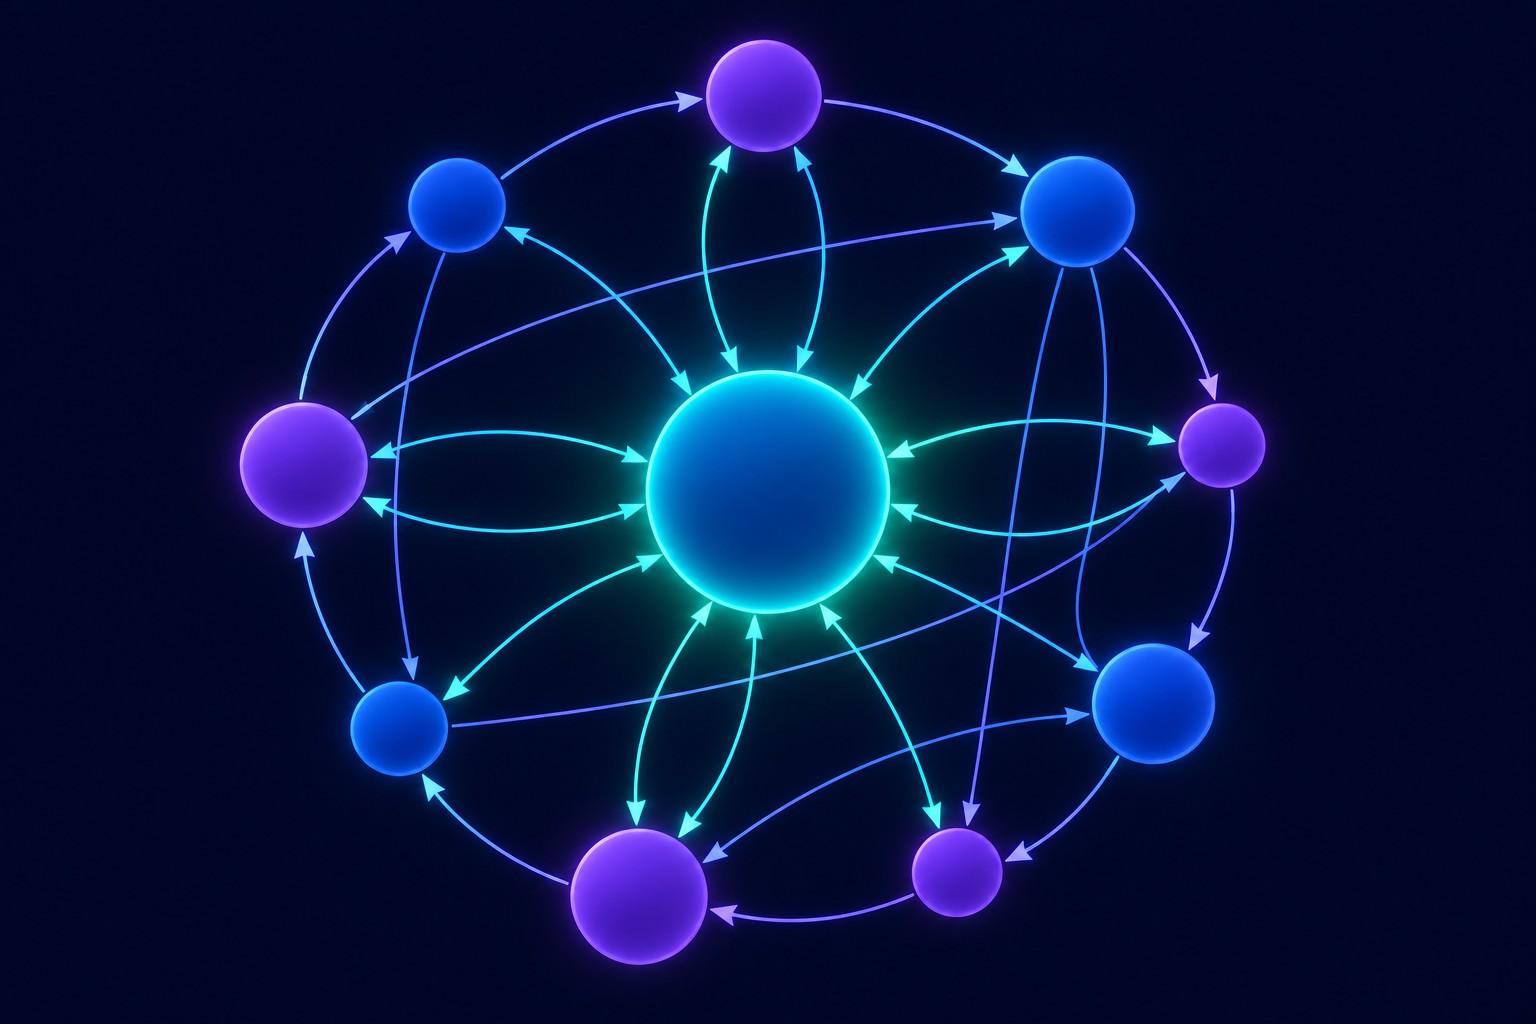
Поисковая база строит обратный индекс: для каждого слова хранится список документов, в которых оно встречается. Принцип — как предметный указатель в книге, только для миллионов документов. Это делает полнотекстовый поиск в тысячи раз быстрее, чем перебор записей методом LIKE в SQL.
Elasticsearch и его открытый форк OpenSearch — стандарт для этого класса задач. Система умеет ранжировать результаты по релевантности, работать с морфологией и анализировать неструктурированный текст. Применение: полнотекстовый поиск на сайтах и в каталогах, мониторинг и анализ системных логов, агрегация событий из разных источников.
Хотите сменить профессию или повысить квалификацию?
Федеральный проект «Активные меры содействия занятости» даёт возможность пройти обучение бесплатно за счёт государства
Обычная база хранит данные на диске и загружает нужные блоки в оперативную память при запросе. In-Memory база хранит всё непосредственно в RAM — это полностью устраняет самую медленную часть ввода-вывода, обращение к диску. Задержка снижается с миллисекунд до микросекунд.
Redis совмещает два типа: Key-Value Store и In-Memory. Memcached — более простой аналог только для кэширования без дополнительных структур данных. Применение: биржевые торги в реальном времени, счётчики активных сессий, таблицы лидеров онлайн-игр, аналитика событий с требованием к минимальной задержке.
NoSQL — специализация, а не универсальная замена реляционных баз данных. Преимущества нереляционных баз данных раскрываются при масштабе и высокой нагрузке. Выбор определяют четыре вопроса.
| Сценарий |
Рекомендуемый тип NoSQL |
|---|---|
| Кэш и сессии пользователей | Key-Value (Redis) |
| Гибкий каталог товаров | Документная (MongoDB) |
| Аналитика IoT-потоков | Столбцовая (ClickHouse) |
| Граф друзей, рекомендации | Графовая (Neo4j) |
| Поиск по контенту | Поисковая (Elasticsearch) |
При небольшом объёме данных со сложной бизнес-логикой SQL остаётся оптимальным выбором. Когда данные растут нелинейно, структура часто меняется или нагрузка распределена по множеству узлов — NoSQL становится правильным решением.
Нереляционные базы данных используют там, где объём и скорость данных превышают возможности реляционных систем.
Социальные сети — типичный гибрид: графовая база хранит граф дружбы и рекомендаций, документная — профили и ленты событий, Key-Value — кэш сессий и счётчики активности.
Стриминговые платформы сохраняют историю просмотров, оценки и поведенческие сигналы в документных и столбцовых базах, строя рекомендации через анализ реальных данных предпочтений пользователей.
FinTech чаще всего использует связку SQL + NoSQL: транзакции и баланс — в реляционной базе с ACID, аналитика поведения клиентов и граф антифрода — в NoSQL.
IoT и промышленный мониторинг — столбцовые базы для временны́х рядов от датчиков. Потоки с тысяч сенсоров одновременно — классический сценарий для ClickHouse и Cassandra.
Три направления определяют эволюцию нереляционных баз данных в 2025 году.
Векторные базы данных — специализированный тип NoSQL для хранения векторных представлений данных (эмбеддингов). Используются в AI-системах с архитектурой RAG (Retrieval-Augmented Generation — поиск с дополнением генерации): вместо точного совпадения ищут «похожие» объекты по семантическому расстоянию между векторами. По классификации Gartner — один из ключевых трендов управления данными на 2025 год.
Lakehouse (озеро-хранилище) — архитектура, объединяющая гибкость Data Lake (озера данных) и аналитические возможности Data Warehouse (хранилища данных). Gartner относит её к трансформационным технологиям ближайших лет.
Polyglot Persistence — подход, сформулированный Мартином Фаулером: «правильный инструмент для правильной задачи». В одной системе сосуществуют несколько типов баз данных: PostgreSQL для финансовых транзакций, MongoDB для профилей пользователей, Redis для кэша сессий, Elasticsearch для поискового функционала. Не выбор единой «лучшей» базы — а оркестрация специализированных инструментов.
Да. Redis относится одновременно к двум типам NoSQL: Key-Value Store (пары ключ-значение) и In-Memory (данные хранятся в RAM). Поддерживает команды SET, GET, DEL, INCR и обеспечивает субмиллисекундный доступ. Открытый исходный код, лицензия BSD, клиентские библиотеки для Python, JavaScript, Java. Применяется для кэширования, сессий пользователей и биржевых торгов в реальном времени.
SQL хранит данные в жёстких таблицах (Schema-on-Write), масштабируется вертикально — нужен более мощный сервер — и гарантирует ACID-транзакции. NoSQL хранит данные в «естественном» виде: документ, граф, столбцы, ключ-значение. Схема гибкая (Schema-on-Read), масштабирование горизонтальное — добавляй серверы. Транзакции по модели BASE. Коротко: SQL — точность и стабильность, NoSQL — скорость и гибкость при больших нагрузках.
Да, это называется Polyglot Persistence — стандарт современных enterprise-приложений (термин Мартина Фаулера). Типичный стек: PostgreSQL для финансовых транзакций, MongoDB для профилей пользователей, Redis для кэша сессий, Elasticsearch для поискового функционала. Каждый инструмент решает задачу, для которой он создан. NoSQL не конкурирует с SQL — он дополняет его там, где реляционная модель неэффективна.
Теорема CAP (Эрик Брюэр, 2000) гласит: в распределённой системе нельзя одновременно гарантировать Consistency (все узлы видят одни данные), Availability (система всегда отвечает) и Partition Tolerance (работает при сбое сети). Поскольку P всегда присутствует, выбор стоит между CP — MongoDB в строгом режиме, HBase — и AP — Apache Cassandra, CouchDB (всегда доступны, данные могут временно запаздывать).
Горизонтальное масштабирование (Scale-Out) — добавление новых серверов в кластер вместо замены одного мощного сервера (Scale-Up). NoSQL проектируется для распределённой работы: данные делятся между десятками узлов. При росте нагрузки добавляется ещё один сервер без остановки сервиса. Apache Cassandra принимает новый узел в кластер автоматически, перераспределяя данные по кластеру.
В трёх сценариях. Сложные JOIN-запросы — объединение данных из нескольких источников в SQL эффективнее. Строгие транзакции — финансовые системы требуют ACID-гарантий, которых модель BASE не даёт. Сложная OLAP-аналитика — агрегации, GROUP BY и работа с временны́ми рядами лучше реализована в реляционных или специализированных хранилищах. Правило простое: NoSQL — операционные нагрузки, SQL — аналитическая точность.
Оба относятся к столбцовым NoSQL-базам, но под разные сценарии. ClickHouse, созданный в Яндексе, заточен под OLAP-аналитику: GROUP BY, агрегации над миллиардами строк, быстрые дашборды. Cassandra — AP-система (CAP), созданная в Facebook для максимальной скорости записи и глобальной доступности. ClickHouse идеален для аналитики, Cassandra — для операционных нагрузок с высокой частотой записи: IoT, события реального времени.
Schema-on-Read — подход, при котором структура данных не фиксируется при записи, а интерпретируется при чтении. В SQL сначала создаётся таблица с полями (Schema-on-Write), только потом записываются данные. NoSQL позволяет записывать данные любой структуры немедленно, добавлять новые поля без изменения схемы. Особенно ценно, когда модель данных быстро меняется — профили пользователей, каталоги товаров с переменным набором характеристик.
WORM (Write Once, Read Many — однократная запись, многократное чтение) — принцип неизменяемости: после записи данные не обновляются, изменения фиксируются как новые записи. Гарантирует целостность истории для аудита и логов. MPP (массово-параллельная обработка, Massively Parallel Processing) — архитектура, при которой запрос распределяется между десятками узлов, каждый обрабатывает свою часть. Так столбцовые базы — ClickHouse, Greenplum — обрабатывают терабайты данных за секунды.
Векторные базы данных — специализированный тип NoSQL для хранения векторных представлений (эмбеддингов) данных. Используются для семантического поиска и RAG (Retrieval-Augmented Generation — поиск с дополнением генерации) в AI-системах: вместо точного совпадения ищут «похожие» объекты по расстоянию между векторами. В 2025 году активно интегрируются в существующие NoSQL-платформы. По классификации Gartner — один из ключевых трендов управления данными.
Подайте заявку — забронируйте место в группе
45 000 мест на 2026 год. Бесплатное обучение по федеральному проекту «Активные меры содействия занятости»