База данных (БД) — организованная коллекция данных, которой управляет специализированная программа — СУБД (система управления базами данных). Виды баз данных определяют, как именно данные хранятся, связываются и запрашиваются: от этого зависит производительность, масштабируемость и стоимость системы в целом.
Классификация — не академическая абстракция. PostgreSQL отлично обрабатывает транзакции интернет-магазина, но не предназначен для поиска похожих изображений по нейросетевому эмбеддингу. Redis отвечает на миллион запросов в секунду, но не поможет с аналитикой продаж за год. Выбор типа БД в самом начале экономит месяцы рефакторинга.
В статье — 16 типов СУБД с описанием принципа работы, примерами реализаций и типичными сценариями применения. Сравнительная таблица — в следующем разделе. История классификации начинается в 1970 году, когда математик IBM Эдгар Кодд опубликовал реляционную модель данных и заложил фундамент современного стека хранения.
Все основные виды баз данных делятся на три верхних класса: реляционные (жёсткая схема, SQL, ACID), нереляционные NoSQL (гибкая схема, горизонтальный масштаб, BASE) и NewSQL (реляционная модель плюс горизонтальный масштаб). Внутри каждого класса — подтипы, оптимизированные под конкретные нагрузки. Ниже — навигационная таблица 16 типов перед погружением в каждый из них.
| Тип СУБД |
Класс |
Язык запросов |
Основной use case |
Примеры |
Консистентность |
|---|---|---|---|---|---|
| Реляционные строчные | Реляционные | SQL | OLTP, транзакции | PostgreSQL, MySQL, Oracle | ACID |
| Реляционные колоночные | Реляционные | SQL | OLAP, аналитика | ClickHouse, Vertica, Redshift | ACID |
| Иерархические | Устаревшие | Проприетарный | Историческое, DNS | IMS, файловая система | — |
| Сетевые | Устаревшие | Проприетарный | Историческое | IDMS, CODASYL | — |
| Ключ-значение | NoSQL | API | Кэш, сессии, счётчики | Redis, Memcached, Tarantool | Eventual |
| Документо-ориентированные | NoSQL | MQL / API | Каталоги, профили, CMS | MongoDB, CouchDB, Firebase | Eventual |
| Wide Column | NoSQL | CQL / HQL | Big Data, IoT, телеметрия | Cassandra, HBase | Tunable |
| Графовые | NoSQL | Cypher / Gremlin | Соцсети, фрод-детекция | Neo4j, JanusGraph, ArangoDB | ACID / Eventual |
| Временны́е ряды | NoSQL | PromQL / Flux | Мониторинг, IoT, котировки | Prometheus, InfluxDB, VictoriaMetrics | Eventual |
| Поисковые | NoSQL | DSL / Lucene | Полнотекстовый поиск | Elasticsearch, Manticore, Sphinx | Eventual |
| Векторные | NoSQL | ANN API | RAG, семантический поиск | Milvus, Qdrant, Pinecone | Eventual |
| RDF | NoSQL | SPARQL | Граф знаний, linked data | AllegroGraph, Apache Jena | Eventual |
| NewSQL | NewSQL | SQL | FinTech, высоконагруженные системы | Google Spanner, CockroachDB | ACID |
| Мультимодальные | Гибридные | SQL / API | Разнородные данные в одной СУБД | ArangoDB, YDB, Tarantool | Varies |
| GEO/GIS | Специализированные | SQL + пространственные | Картография, геосервисы | PostGIS, SpatiaLite | ACID |
| Event / XML | Специализированные | Event API / XQuery | Аудит, XML-документы | EventStoreDB, BaseX | Varies |
До появления СУБД данные хранились в обычных текстовых файлах — /etc/passwd, CSV-таблицы, конфигурационные файлы. Простейший пример живёт в Unix-системах до сих пор. Главный минус: поиск линейный, совместный доступ и целостность не гарантированы. Эти ограничения подтолкнули к созданию первых специализированных моделей хранения. Виды моделей баз данных сменяли друг друга по мере роста объёмов и сложности задач: иерархическая, сетевая, реляционная, NoSQL — и сегодня NewSQL с векторными хранилищами.
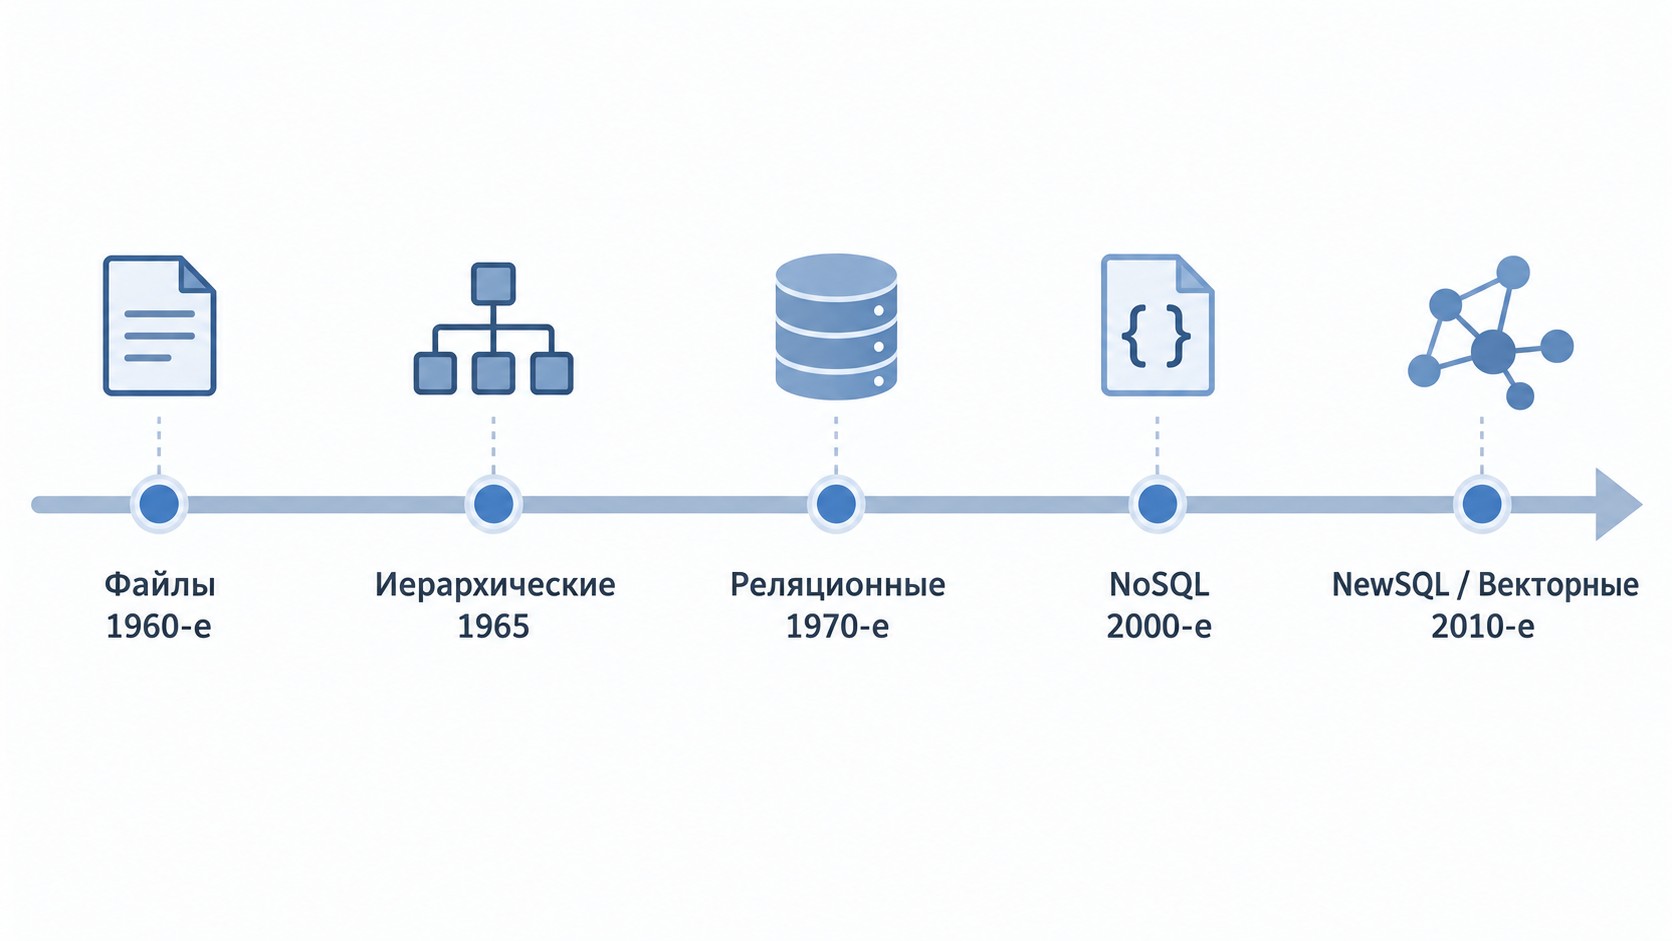
Иерархическая БД организует данные как дерево: один родительский узел, N дочерних. Примером иерархической базы данных является файловая система и DNS — зоны, домены, поддомены выстраиваются в строгую вертикаль. Ограничение: связь «многие-ко-многим» невозможна по определению.
Сетевая модель (IDMS, CODASYL) снимает это ограничение — потомок может иметь несколько родителей. Но навигация требует знания физической структуры хранения, что делает такие иерархические и сетевые базы данных жёсткими при изменении схемы. Обе модели вышли из продакшена, их значение сегодня — историческое.
В 1970 году математик IBM Эдгар Кодд опубликовал статью «A Relational Model of Data for Large Shared Data Banks». Ключевой сдвиг: декларативный SQL-доступ вместо навигации по указателям. Разработчик описывает что хочет получить, а не как пройти по структуре данных.
Результат — реляционные базы данных стали доминирующей технологией на десятилетия. По данным DB-Engines, к 2024 году существует 166+ реляционных СУБД: PostgreSQL, MySQL, Oracle, MS SQL Server и сотни нишевых реализаций. Реляционная модель и сетевые базы данных — полные противоположности по подходу к связям.
Реляционная БД хранит данные в таблицах: строка — один объект (запись), столбец — одно свойство. Таблицы связываются через внешние ключи. Язык запросов — SQL. Основа парадигмы — нормализация данных и гарантии ACID-транзакций.
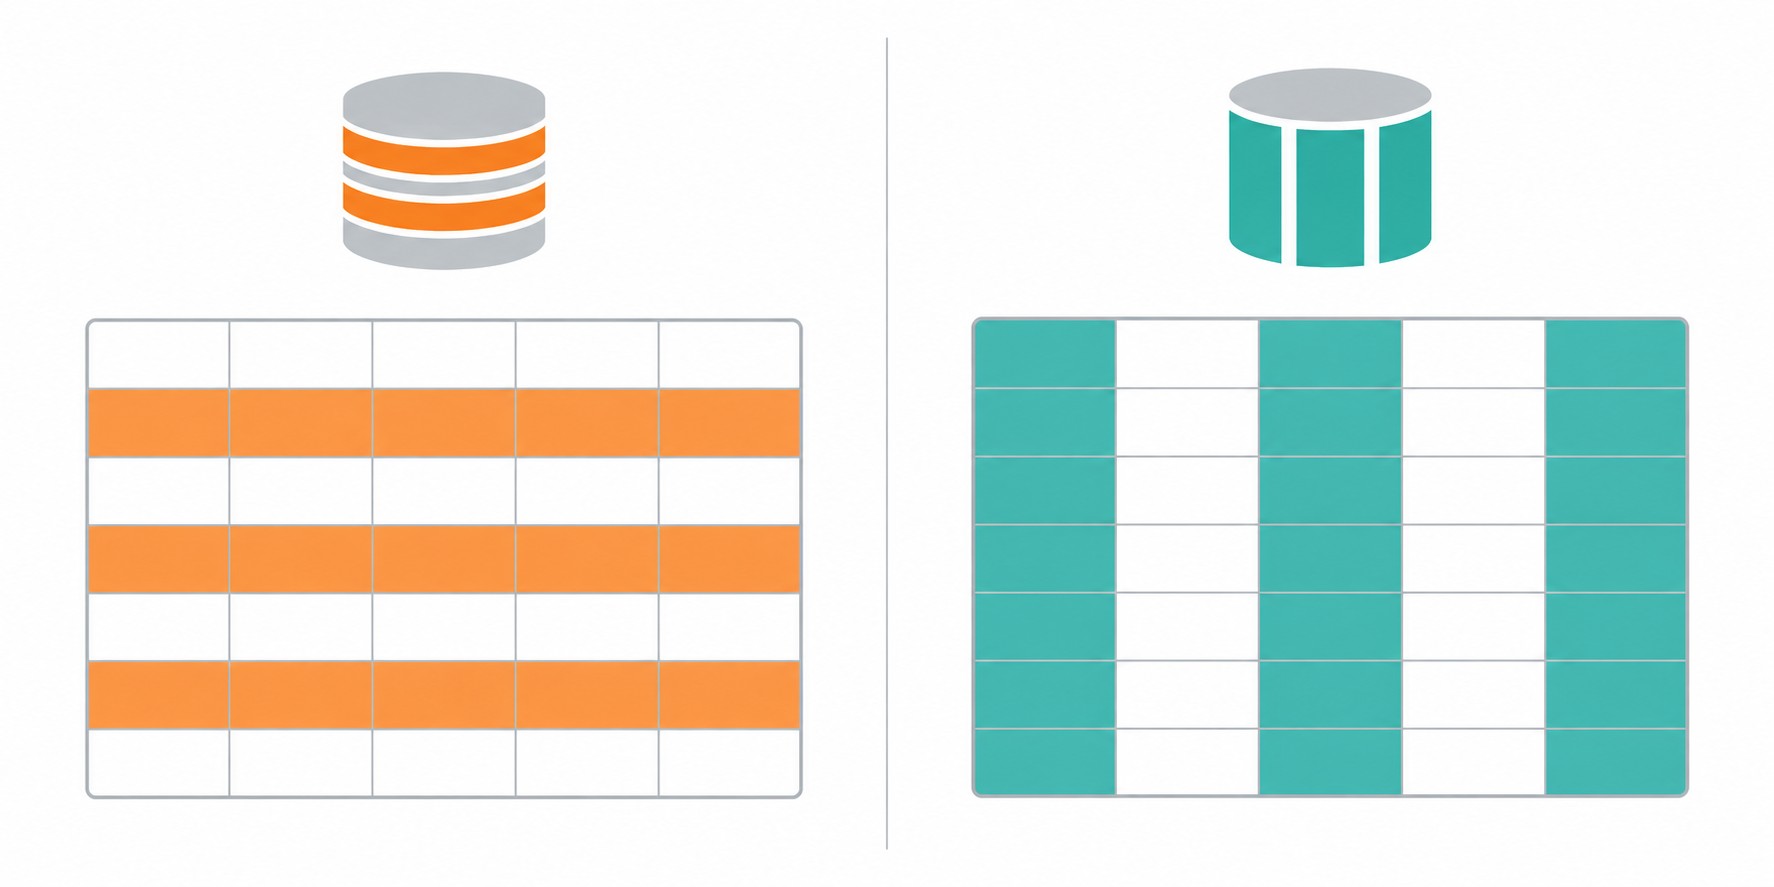
Реляционные БД делятся на два подкласса. Строчные хранят данные построчно и оптимизированы для OLTP — транзакционных операций: вставка, обновление, удаление отдельных записей. Колоночные хранят данные по столбцам, что даёт кратное ускорение OLAP-запросов: агрегации по одному полю читают только нужный столбец. Преимущества: сложные связи, декларативный SQL, зрелая экосистема. Ограничения: жёсткая схема требует миграций, горизонтальный масштаб сложен без специальных инструментов.
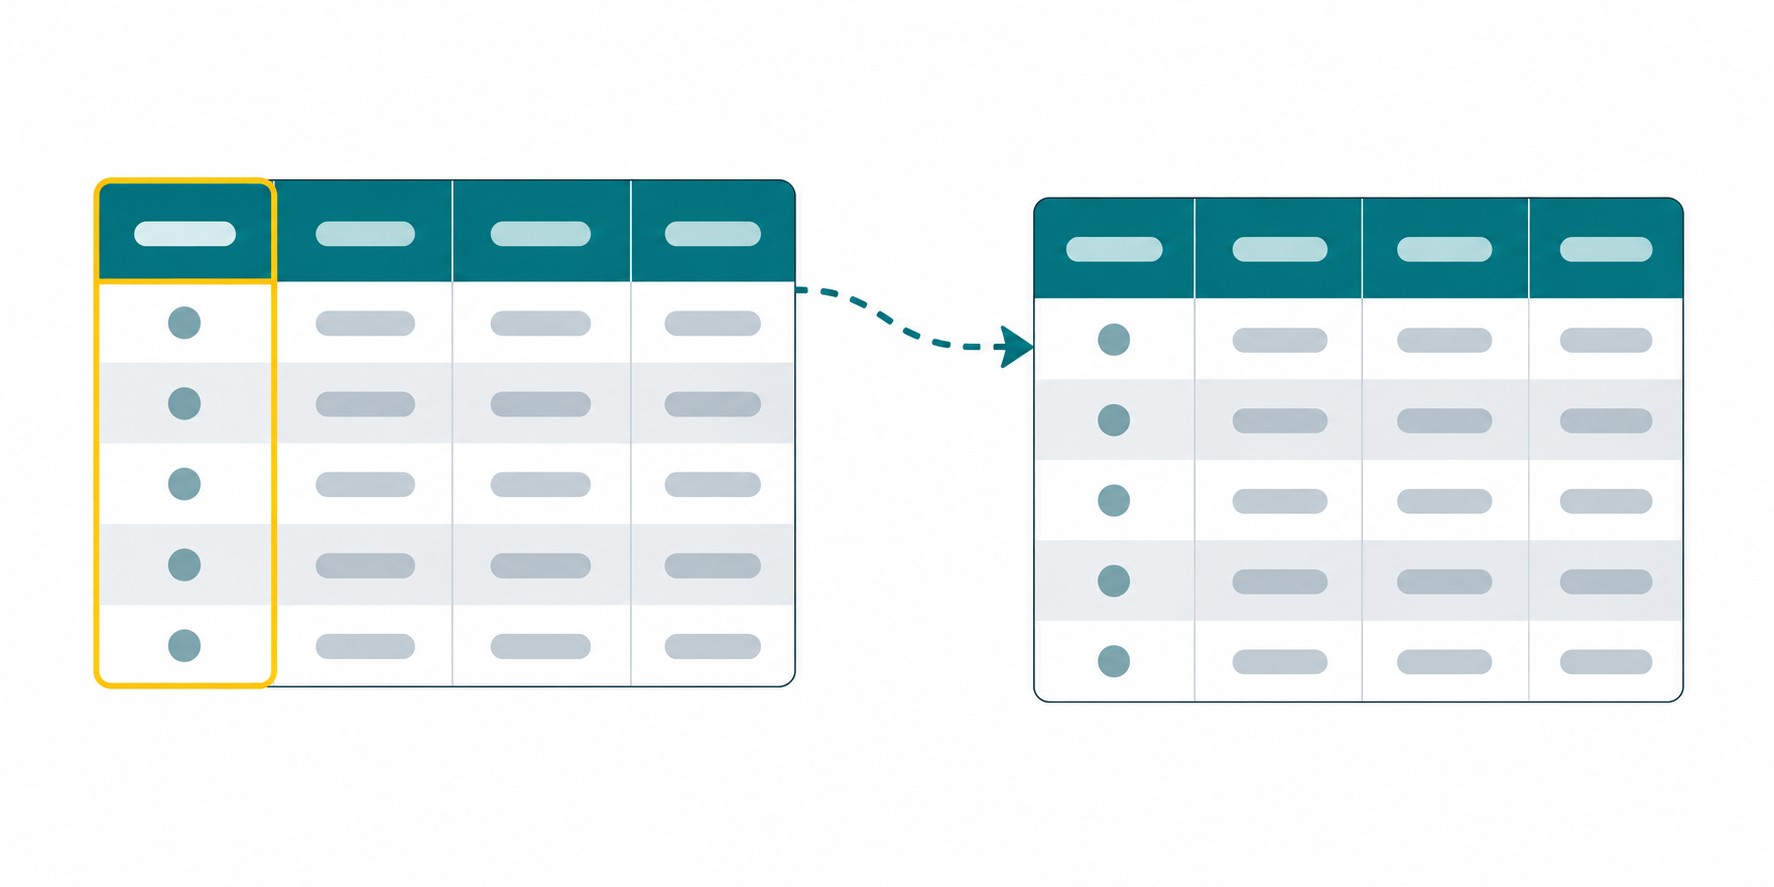
Нормализация — процесс минимизации избыточности данных через разбиение таблиц с помощью внешних ключей. Каждый вид нормализации баз данных описывается нормальной формой:
Виды связей таблиц в базах данных: «один к одному» (1:1), «один ко многим» (1:N), «многие ко многим» (N:M). Связь N:M реализуется через промежуточную таблицу с двумя внешними ключами. Нормализация снижает избыточность данных и повышает целостность, но увеличивает число JOIN-запросов.
Денормализация — намеренный отказ от нормализации: часто запрашиваемые поля дублируются в основной таблице, чтобы убрать лишние JOIN. Ускоряет запросы на выборку и агрегацию, но усложняет UPDATE и ALTER TABLE — изменение нужно вносить в несколько мест одновременно, иначе данные рассинхронизируются.
Практический пример: в мессенджере поля chat_name и unread_msg_count дублируются прямо в таблице user_chat_link. Главный экран загружается без дополнительных запросов — нагрузка на сервер снижается. Денормализацию применяют только после того, как оптимизация индексов и настройка запросов уже исчерпаны.
ACID — набор гарантий реляционных транзакций:
Жёсткий ACID несовместим с горизонтальным шардированием: при распределённой транзакции гарантировать изоляцию без координирующего узла практически невозможно. Поэтому SQL и NoSQL придерживаются разных моделей. NoSQL переходит к BASE: Basically Available (базовая доступность), Soft state (мягкое состояние), Eventually consistent (согласованность в конечном счёте). Меньше гарантий — больше горизонтального масштаба и отказоустойчивость без единой точки отказа.
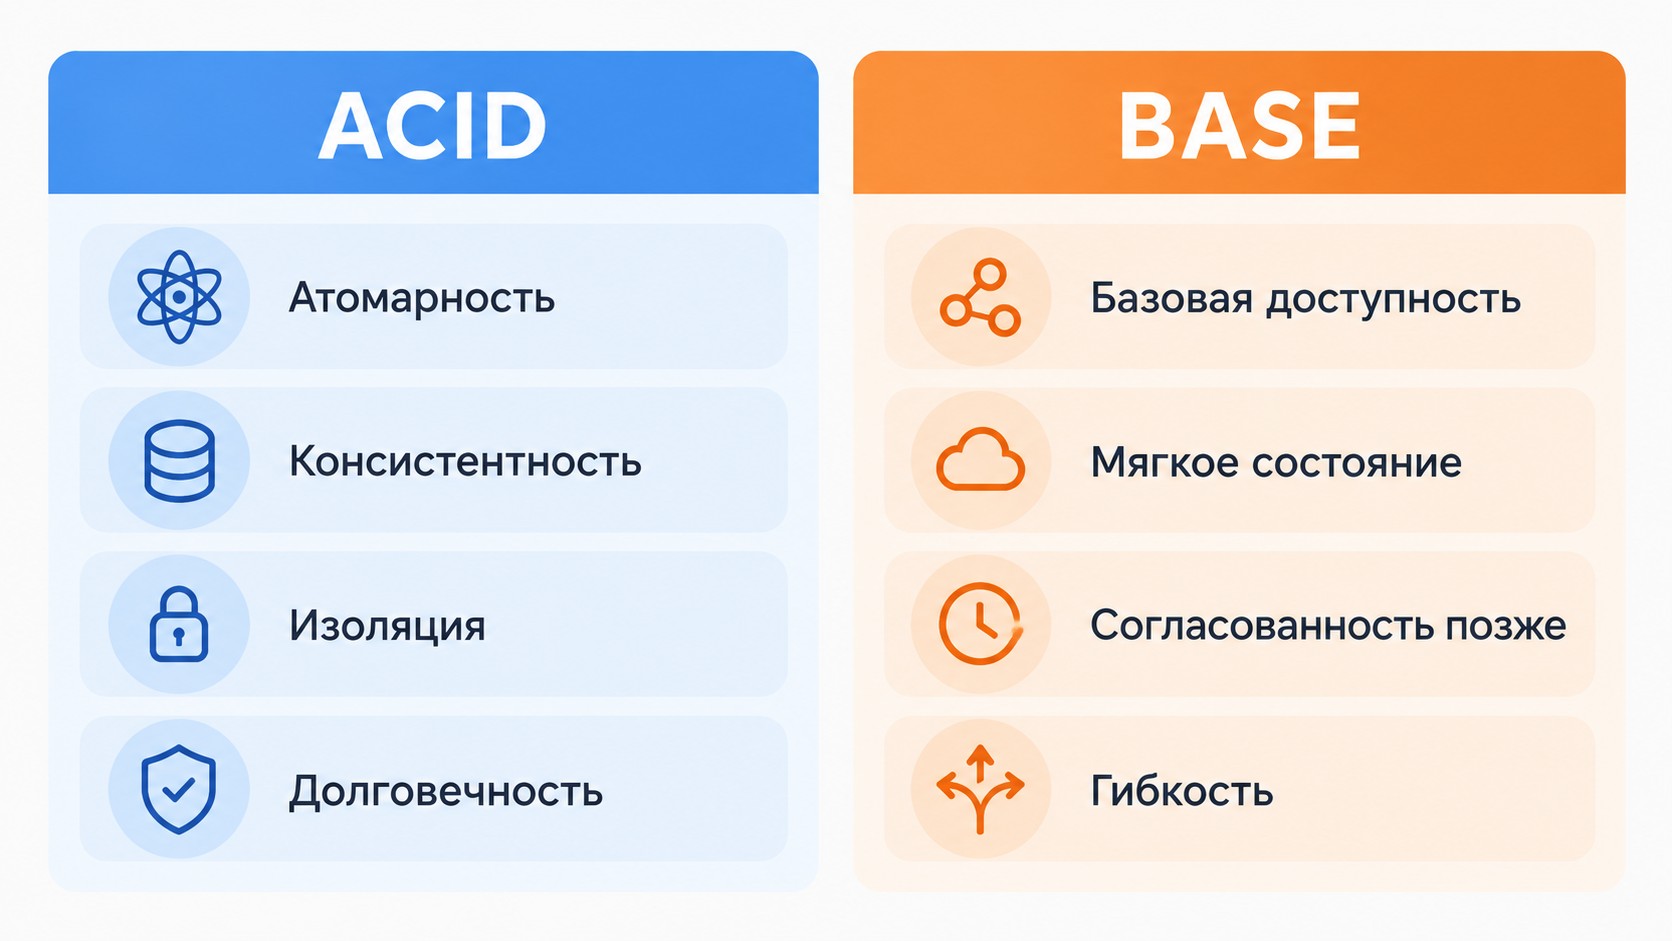
Строчные (OLTP): PostgreSQL, MySQL, MariaDB, SQLite — открытый код; Oracle, MS SQL Server — коммерческие лицензии.
Колоночные (OLAP): ClickHouse (разработан Яндексом, Open Source, рекордная скорость агрегации), Vertica, Amazon Redshift, Google BigQuery.
Российские: Postgres Pro (энтерпрайз-форк PostgreSQL с поддержкой на русском и сертификацией ФСТЭК), Jatoba, Arenadata DB (на базе Greenplum), YDB (Яндекс, serverless, Open Source, поддерживает KV- и SQL-интерфейсы одновременно).
Проектирование схем данных и работу с SQL удобно изучать системно — на курсе по базам данных и SQL разбирается реляционная модель, нормализация и практика с PostgreSQL. Дальше рассмотрим нереляционные типы, которые строятся на совсем других принципах.
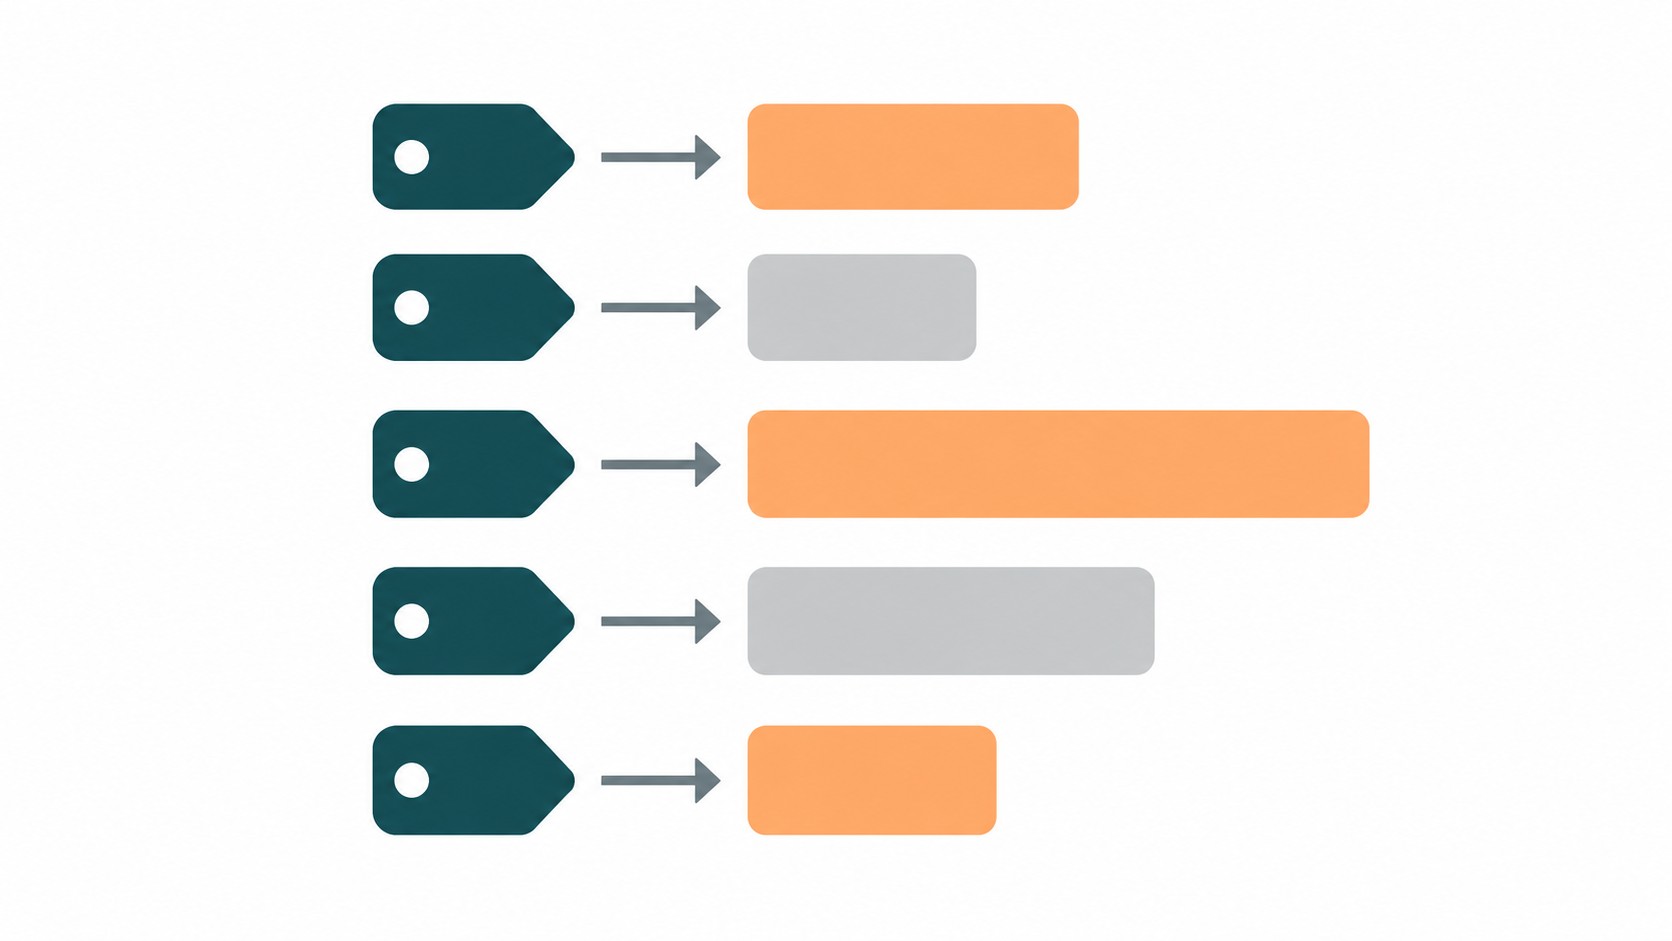
Простейший тип нереляционных хранилищ: каждый объект — пара ключ → значение. Значением может быть строка, число, список, хэш или бинарный blob — СУБД ничего не знает о структуре значения. Хранение в памяти (in-memory) обеспечивает почти мгновенный доступ: Redis возвращает данные за доли миллисекунды.
Типичные сценарии: кэширование ответов от медленных источников, хранение сессий, счётчики, балансы, очереди задач. Шардирование по ключам позволяет распределить данные между узлами: сессии разных сайтов попадают в разные сегменты кластера — это снижает I/O-нагрузку на основную реляционную БД.
Ограничение: валидация ключей и их нейминг — полностью на стороне разработчика. СУБД не проверяет уникальность форматов. В командах без соглашений возникают коллизии: key:user:123 в одном сервисе и user_123 в другом — данные расходятся незаметно.
Примеры: Redis, Memcached. Российская разработка — Tarantool (Mail.ru Group): гибридная система, сочетающая KV-хранилище, документные и реляционные возможности с Lua-скриптингом в одной СУБД.
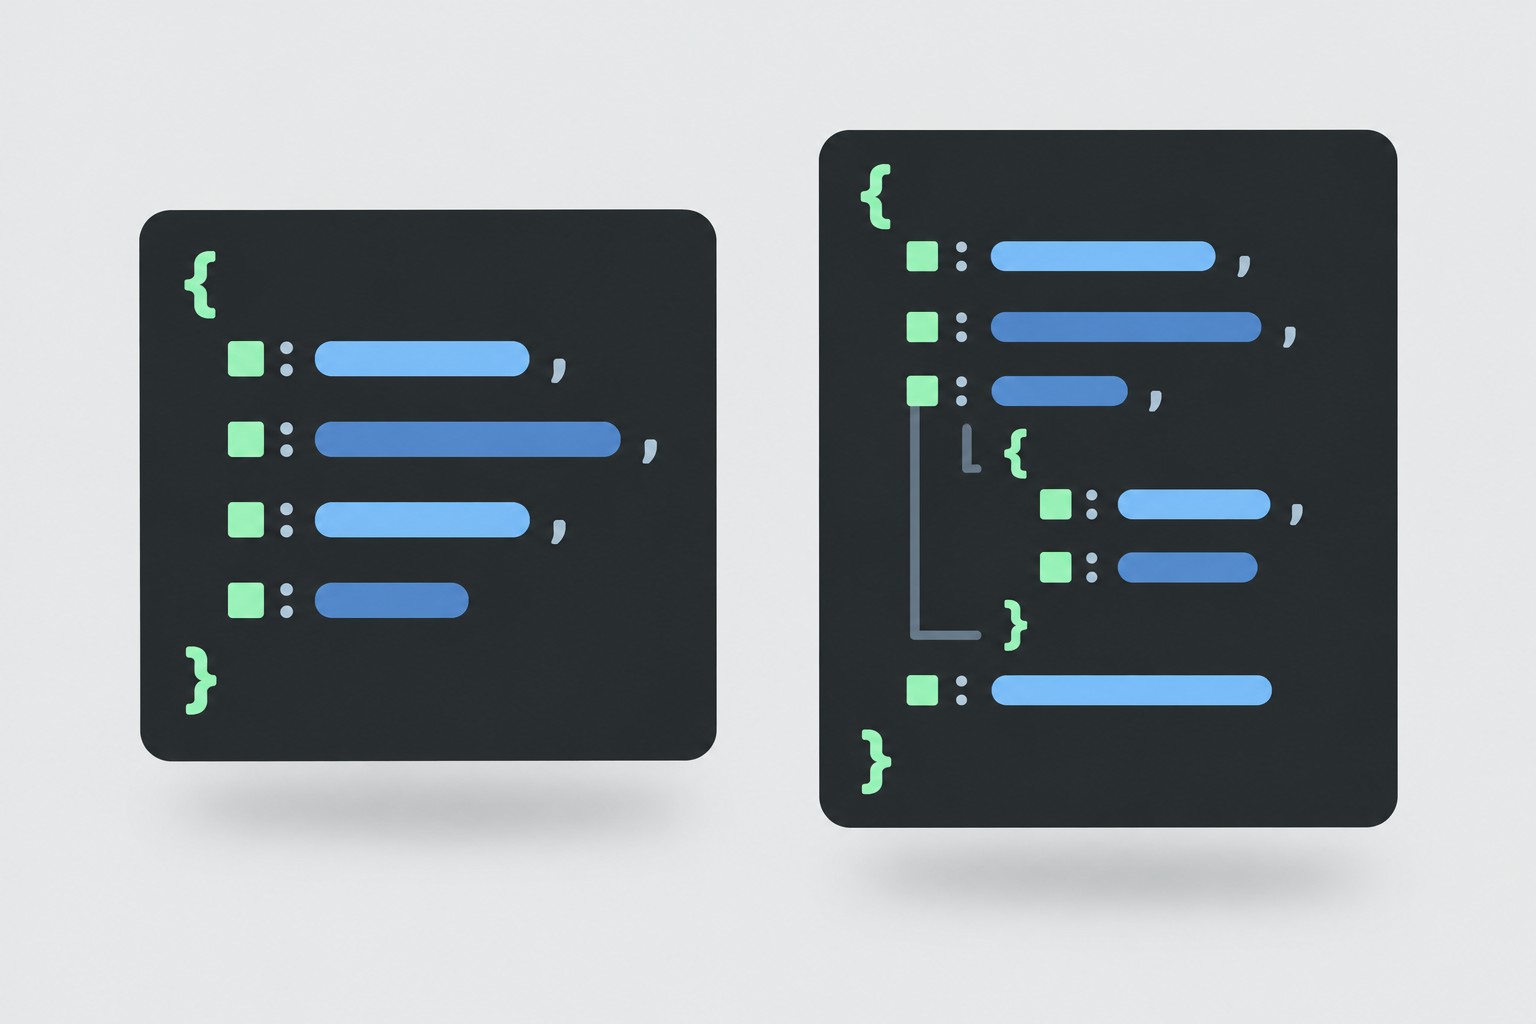
Документо-ориентированные БД хранят данные в виде иерархических документов: JSON, BSON или XML. Документ — дерево свойств с вложенными объектами и массивами. Несколько документов образуют «коллекцию» (аналог таблицы в SQL, но без жёсткой схемы).
Ключевое преимущество — гибкая схема. Каждый документ в коллекции может иметь уникальный набор полей: один пользователь хранит avatar_url, другой — нет. Это упрощает разработку: не нужно описывать схему заранее и писать миграции при добавлении нового поля. При больших объёмах данных с разнородными структурами документная модель работает значительно удобнее реляционной.
Применение: каталоги товаров с разными атрибутами, профили пользователей, CMS-системы, логирование событий.
Ограничение: нет встроенных JOIN между коллекциями; сложные агрегации требуют построения aggregation pipeline вместо простого SQL-запроса.
Примеры: MongoDB (лидер рынка по DB-Engines, 2024), CouchDB, Firebase Firestore. Российская разработка — СУБД Енисей.
Реляционные колоночные СУБД (ClickHouse, Vertica) уже упоминались выше. Здесь рассматриваем нереляционный подтип — Wide Column Stores (хранилища с широкими столбцами).
В Wide Column каждая строка содержит только те столбцы, данные для которых есть. Пустые столбцы не хранятся совсем — экономия при разреженных данных. Столбцы группируются в «семейства» (column families): запрос к нескольким связанным полям читает только нужное семейство, а не всю строку.
Аналитическое преимущество: агрегация по одному столбцу читает только его, а не все строки целиком. При больших объёмах данных это даёт многократный выигрыш в скорости.
Apache Cassandra — высокая пропускная способность записи, линейный горизонтальный масштаб: IoT, телеметрия, история сообщений, активных сессий. Apache HBase строится поверх HDFS (Hadoop Distributed File System) и оптимизирован для таблиц с миллиардами строк. ClickHouse (Яндекс, Open Source) — колоночная реляционная СУБД с рекордной скоростью OLAP-запросов.
Временны́е ряды — данные, упорядоченные по временны́м меткам. Ключевая особенность модели: insert-only — прошлые записи не перезаписываются. Каждое новое измерение добавляется с меткой времени в конец ряда.
Нагрузка write-heavy: IoT-датчики генерируют миллионы точек в секунду. Специализированные временны́е индексы обеспечивают быстрый доступ к диапазонам, агрегацию по интервалам (среднее за час, максимум за сутки) и автоматическое удаление данных по политике хранения (retention policy).
Применение: мониторинг серверов (CPU, RAM, disk I/O), финансовые котировки, телеметрия умных устройств, метрики приложений. Prometheus работает в pull-модели: сам опрашивает сервисы по HTTP и забирает текущие метрики.
Ограничения: производительность зависит от числа уникальных рядов (cardinality) и индексирования. Высокая cardinality — миллионы уникальных комбинаций тегов — деградирует запросы даже на мощном кластере.
Примеры: Prometheus, InfluxDB, VictoriaMetrics (Open Source, хорошо масштабируется горизонтально), TimescaleDB (расширение PostgreSQL), Graphite.
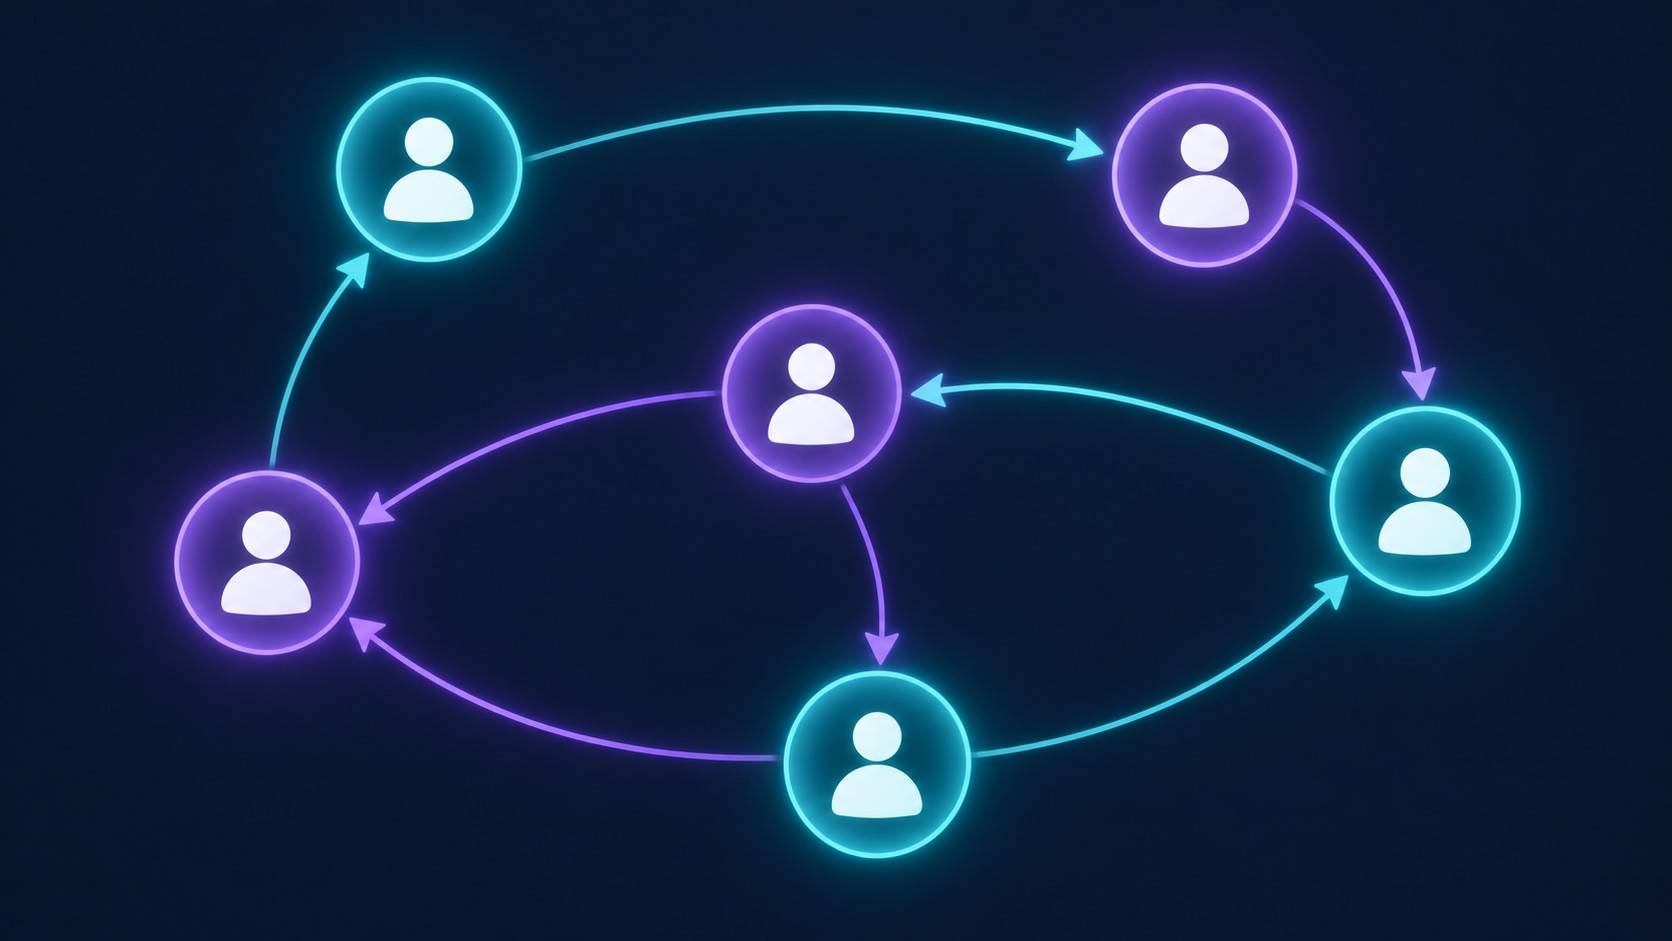
Графовые БД хранят данные как граф: вершины (узлы, объекты) и рёбра (связи между ними). Каждое ребро имеет тип и может нести атрибуты. В основе — теория графов.
Главное преимущество перед реляционными: при 3 и более уровнях связей обход рёбер работает значительно быстрее множественных JOIN. Запрос «найти всех друзей друзей пользователя» в SQL требует нескольких самосоединений; в графовой БД — один traversal.
Применение: социальные сети (рекомендации знакомых), FinTech (выявление мошеннических схем через цепочки связанных аккаунтов), рекомендательные системы, граф знаний.
Язык запросов Cypher (Neo4j): MATCH (u:User)-[:FOLLOWS]->(f) RETURN f.name — читается буквально как «найди пользователей f, на которых подписан u». Это одно из преимуществ графовых хранилищ — запросы близки к человеческому описанию задачи.
Примеры: Neo4j (лидер рынка, Open Source Community + Enterprise), JanusGraph (Apache, горизонтальный масштаб), Dgraph, ArangoDB (мультимодальная: граф + документы + KV).
Хотите сменить профессию или повысить квалификацию?
Федеральный проект «Активные меры содействия занятости» даёт возможность пройти обучение бесплатно за счёт государства
Поисковые СУБД строят инвертированный индекс: слово или лемма → список документов, в которых она встречается. Поиск по готовому индексу в тысячи раз быстрее полнотекстового сканирования по всей коллекции.
Отличие от векторных БД: поисковые работают с лексическими совпадениями (с учётом лемматизации и синонимов), векторные ищут семантическое сходство смыслов. Запрос «купить красные кроссовки» в поисковой БД найдёт документы со словом «кроссовки»; в векторной — документы с похожим смыслом, даже если там написано «спортивная обувь».
Применение: продуктовый поиск на маркетплейсе, полнотекстовый поиск по петабайтам логов, аналитика неструктурированных данных, мониторинг сообщений в SIEM-системах.
Примеры: Elasticsearch / OpenSearch (Apache), Splunk (коммерческий, SIEM), Manticore Search (российская Open Source разработка, форк Sphinx с активным развитием), Sphinx.
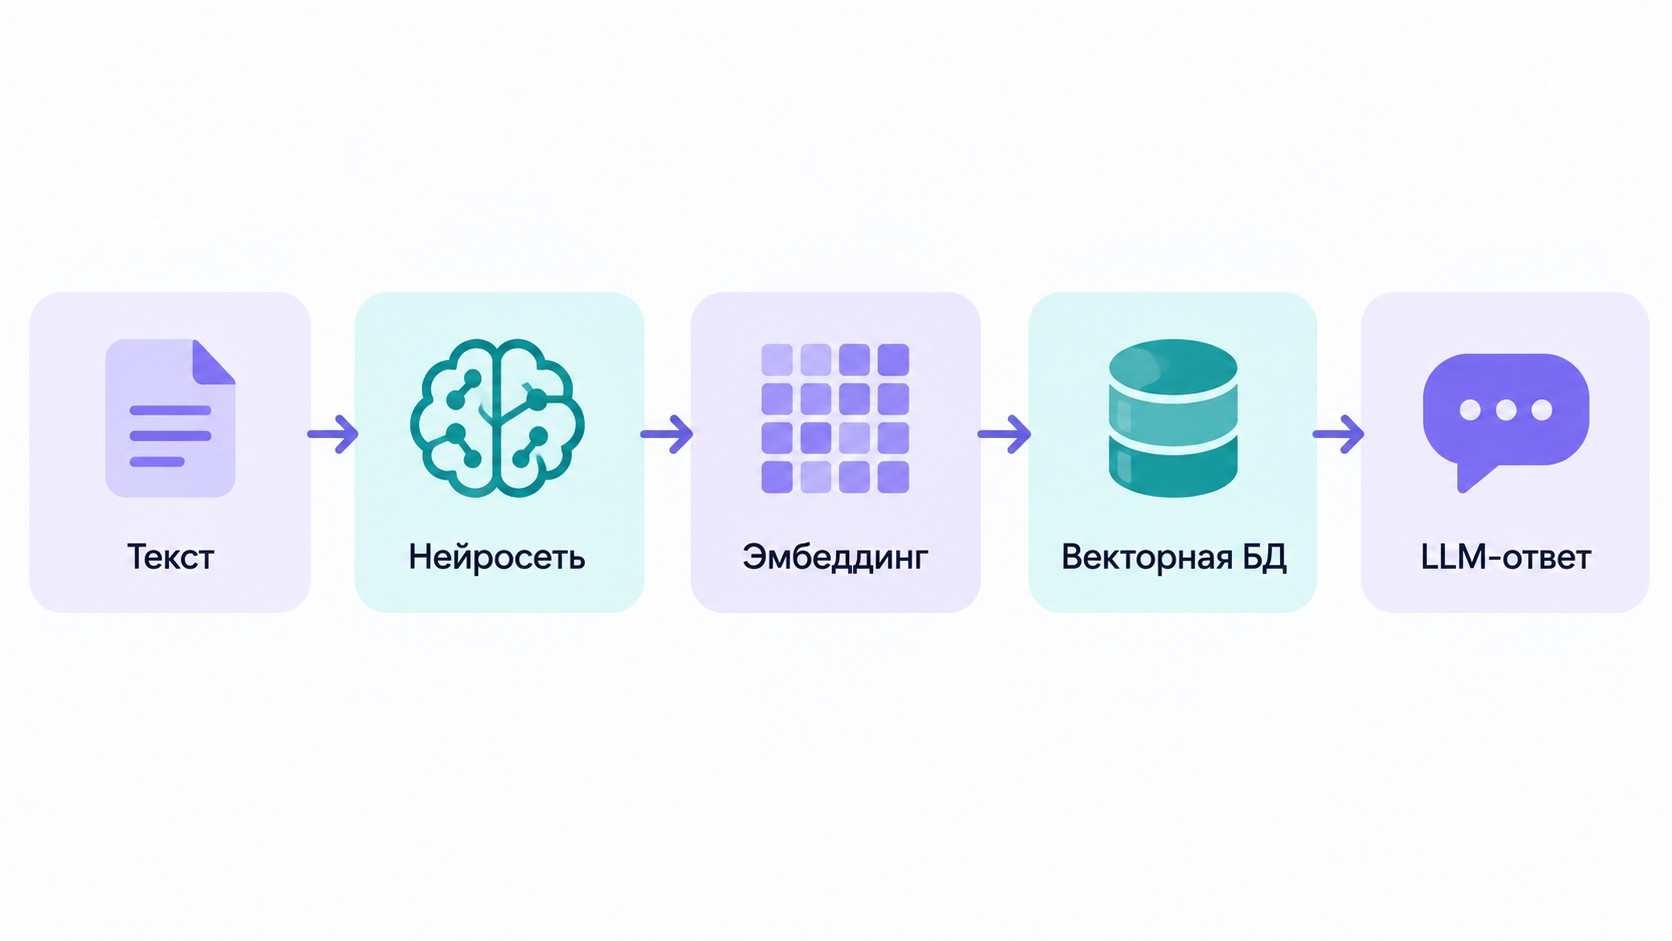
Векторная БД хранит float-векторы-эмбеддинги — числовые представления текстов, изображений или звука, которые нейросеть сжимает в массив из 768–3072 чисел. Объекты, похожие по смыслу, имеют близкие векторы в многомерном пространстве.
Поиск работает через ANN-индексы (Approximate Nearest Neighbor — приближённый поиск ближайших соседей): по косинусному сходству или евклидову расстоянию. ANN жертвует долей точности в пользу скорости: среди миллиарда векторов он находит 99% ближайших за миллисекунды.
Бум 2022–2024 годов — прямое следствие роста LLM (языковых моделей: GPT, Claude, Gemini). Главный сценарий — RAG-системы (Retrieval-Augmented Generation): перед тем как ответить на вопрос, языковая модель достаёт из векторной БД релевантные фрагменты документов и добавляет их в контекст. Это снижает «галлюцинации» и позволяет моделям работать с актуальными корпоративными знаниями без дообучения.
Также: семантический поиск, идентификация по лицу, NLP-пайплайны, рекомендательные системы на основе смыслового сходства.
Примеры: Milvus (Apache, Open Source, высокий горизонтальный масштаб), Weaviate, Pinecone (облачный SaaS), Chroma (лёгкий вариант для прототипов). Российская разработка — Qdrant (Open Source, написан на Rust, высокая производительность при поиске).
RDF (Resource Description Framework) — W3C-стандарт для представления данных в виде триплетов: субъект – предикат – объект. Пример: «Эдгар Кодд — разработал — Реляционную модель». Субъекты и объекты адресуются через URI, что делает каждый факт глобально уникальным.
Язык запросов — SPARQL (аналог SQL для RDF-графов). Применяется в семантической паутине (Semantic Web), графах знаний (Wikidata, DBpedia), связанных открытых данных (linked open data) и семантических аннотациях медицинских и научных данных.
Нереляционные базы данных этого типа нишевые: большинство продуктов не нуждаются в формальной W3C-семантике. Но для задач, где важна машиночитаемая семантика связей между понятиями, RDF-хранилища незаменимы.
Примеры: AllegroGraph, Apache Jena TDB (Open Source), Virtuoso (гибридная: RDF + SPARQL + SQL), GraphDB.
Термин предложил аналитик Мэтью Аслет из 451 Group в 2011 году: реляционная модель данных с горизонтальным масштабом. NewSQL сохраняет SQL и ACID-гарантии, одновременно добавляя возможности, которых нету классических РСУБД.
Механизм: автоматическое шардирование (данные делятся между узлами без участия приложения) в сочетании с алгоритмами консенсуса — Paxos или Raft — для согласованности распределённых транзакций. Горизонтальное масштабирование прозрачно для разработчика: пишешь обычный SQL, шардирование происходит на уровне СУБД.
В отличие от NoSQL, NewSQL не жертвует транзакционностью ради масштаба. Это делает его применимым там, где нужны и ACID, и высокая нагрузка одновременно: финансовые платформы, медицинские системы, глобальный e-commerce.
Примеры: Google Spanner (глобально распределённая, проприетарная), CockroachDB (Open Source, аналог Spanner), VoltDB, MemSQL, YugabyteDB.
Мультимодальная СУБД поддерживает несколько моделей данных одновременно: документы, граф, ключ-значение и реляционные таблицы — в одной системе с единым механизмом согласованности. Один запрос может обращаться к данным разных типов без нарушения целостности.
Большинство реальных продуктов работают с разнородными данными. Профиль пользователя — документ, социальный граф контактов — граф, сессионный токен — KV, история транзакций — реляционная таблица. Держать четыре отдельные СУБД дорого в обслуживании; мультимодальная закрывает все сценарии одним инфраструктурным компонентом.
Примеры: ArangoDB (документы + граф + KV, Open Source), YDB (Яндекс, serverless, поддерживает KV и SQL-интерфейсы), Tarantool (KV + документы + реляционные возможности с Lua-скриптингом).
Несколько нишевых типов, которые стоит знать при выборе инструмента:
Виды резервного копирования баз данных напрямую связаны с требованиями к RPO (Recovery Point Objective — допустимая потеря данных) и RTO (Recovery Time Objective — допустимое время восстановления).
Полное (full) — полная копия всей БД. Простое восстановление: достаточно одного файла. Минус: долгое создание и высокое потребление места. Для большой PostgreSQL-базы pg_dump может занимать несколько часов, в течение которых нагрузка на сервер возрастает.
Инкрементальное — копируются только данные, изменившиеся с момента последнего любого бэкапа (полного или инкрементального). Быстрое создание, минимальный объём файлов. Сложность: для восстановления нужна цепочка из полного бэкапа плюс все последующие инкрементальные по порядку. Потеря одного звена делает восстановление к нужной точке невозможным.
Дифференциальное — изменения с момента последнего полного бэкапа. Компромиссный вариант: создание быстрее, чем full; восстановление проще, чем инкрементальное — нужен только полный бэкап и последний дифференциальный.
Репликация (синхронная и асинхронная) — непрерывная передача изменений на реплику. Защищает от аппаратного сбоя мастера: реплика принимает нагрузку за секунды. Но репликация не заменяет бэкап при логической ошибке — случайный DROP TABLE мгновенно реплицируется на все узлы, и откат возможен только из резервной копии.
Особенности по типам СУБД:
Отказоустойчивость системы строится из трёх элементов: бэкап (защита от логических ошибок) + репликация (защита от аппаратных сбоев) + регулярная проверка корректности бэкапов путём тестового восстановления.
Выбор вида базы данных — архитектурное решение на годы. Менять СУБД под продакшен-нагрузкой стоит дорого.
Ключевые критерии:
| Сценарий |
Рекомендуемый тип |
Примеры СУБД |
|---|---|---|
| Финансовые транзакции, строгий ACID | Реляционные строчные | PostgreSQL, Oracle |
| Аналитика и агрегации по большим объёмам | Реляционные колоночные | ClickHouse, Redshift |
| Кэш, сессии, счётчики | Ключ-значение | Redis, Memcached |
| Гибкая схема, быстрая разработка | Документо-ориентированные | MongoDB, Firebase |
| Big Data, высокая пропускная запись | Wide Column | Cassandra, HBase |
| Социальные сети, фрод, рекомендации | Графовые | Neo4j, ArangoDB |
| IoT, мониторинг серверов | Временны́е ряды | Prometheus, VictoriaMetrics |
| RAG / LLM, семантический поиск | Векторные | Qdrant, Milvus |
| Полнотекстовый поиск по логам и контенту | Поисковые | Elasticsearch, Manticore |
| ACID + горизонтальный масштаб | NewSQL | CockroachDB, Google Spanner |
В большинстве современных продуктов применяют полиглотное хранение (polyglot persistence): PostgreSQL для транзакций, Redis для кэша, Elasticsearch для поиска. Это норма, а не признак плохой архитектуры.
Базы данных делятся на три класса: реляционные (SQL, ACID-транзакции), нереляционные NoSQL (ключ-значение, документные, графовые, колоночные, векторные и другие) и NewSQL (реляционная модель + горизонтальный масштаб). В школьной информатике традиционно выделяют три модели: иерархическую, сетевую и реляционную — как основные этапы эволюции СУБД.
Реляционные БД хранят данные в таблицах с жёсткой схемой и используют SQL с ACID-гарантиями. Нереляционные (NoSQL) работают с гибкими форматами — документы, графы, векторы — и следуют модели BASE: нет жёсткой схемы, зато выше горизонтальная масштабируемость. Выбор зависит от структуры данных и требований к транзакционной согласованности.
Нормализация — минимизация избыточности данных через разбиение таблиц с помощью внешних ключей. Основные нормальные формы: 1НФ (атомарность значений полей), 2НФ (полная зависимость от первичного ключа), 3НФ (отсутствие транзитивных зависимостей), BCNF (полная детерминантная зависимость). Чем выше форма — тем меньше избыточность и выше целостность данных.
Векторная БД хранит числовые эмбеддинги — выходы нейросетей, кодирующие смысл текста, изображений или звука. Поиск ведётся не по точному совпадению, а по математической близости (косинусное сходство). Применяется в RAG-системах на LLM, семантическом поиске, идентификации по лицу. Примеры: Milvus, Qdrant (российская разработка), Pinecone, Weaviate.
Графовые БД эффективны, когда приложение активно работает со связями объектов на 3+ уровнях: социальные сети, рекомендательные системы, фрод-детекция в FinTech. Обход вершин и рёбер значительно быстрее множественных JOIN при глубоких цепочках связей. Если данные преимущественно табличные с простыми связями — реляционная СУБД предпочтительнее.
В разработке приложений чаще всего встречаются PostgreSQL и MySQL (реляционные, OLTP), Redis (кэш, сессии), MongoDB (гибкая схема, документы), Elasticsearch (полнотекстовый поиск), ClickHouse (аналитика). Выбор определяется нагрузочной моделью: транзакции → PostgreSQL; неструктурированные данные → MongoDB; высокая скорость чтения → Redis.
NewSQL — класс СУБД (термин Мэтью Аслета, 2011), сохраняющий реляционную модель и ACID-гарантии, но добавляющий горизонтальное масштабирование через шардирование и алгоритмы консенсуса (Paxos, Raft). В отличие от NoSQL, NewSQL не жертвует транзакционностью ради масштаба. Примеры: Google Spanner, CockroachDB, VoltDB.
Среди российских СУБД: реляционные — Postgres Pro, Jatoba, Arenadata DB; ключ-значение — Tarantool (Mail.ru Group); мультимодальные — YDB (Яндекс, serverless, Open Source); колоночные — ClickHouse (Яндекс); векторные — Qdrant; документные — СУБД Енисей. Большинство построены на зрелых Open Source-проектах с корпоративной поддержкой и адаптацией для российского рынка.
Три вида: полное (full) — полная копия, простое восстановление, долгое создание; инкрементальное — только изменения с последнего любого бэкапа, быстрое создание, сложная цепочка восстановления; дифференциальное — изменения с последнего полного, компромиссный вариант. Репликация защищает от аппаратных сбоев, но не заменяет бэкап при логических ошибках в данных.
SQL — основной язык реляционных СУБД двух подтипов: строчные (PostgreSQL, MySQL, MariaDB, Oracle — для OLTP-транзакций) и колоночные (ClickHouse, Vertica, Amazon Redshift — для OLAP-аналитики). SQL также поддерживается в NewSQL-системах (Google Spanner, CockroachDB) и ряде мультимодальных СУБД (YDB, ArangoDB).
Подайте заявку — забронируйте место в группе
45 000 мест на 2026 год. Бесплатное обучение по федеральному проекту «Активные меры содействия занятости»