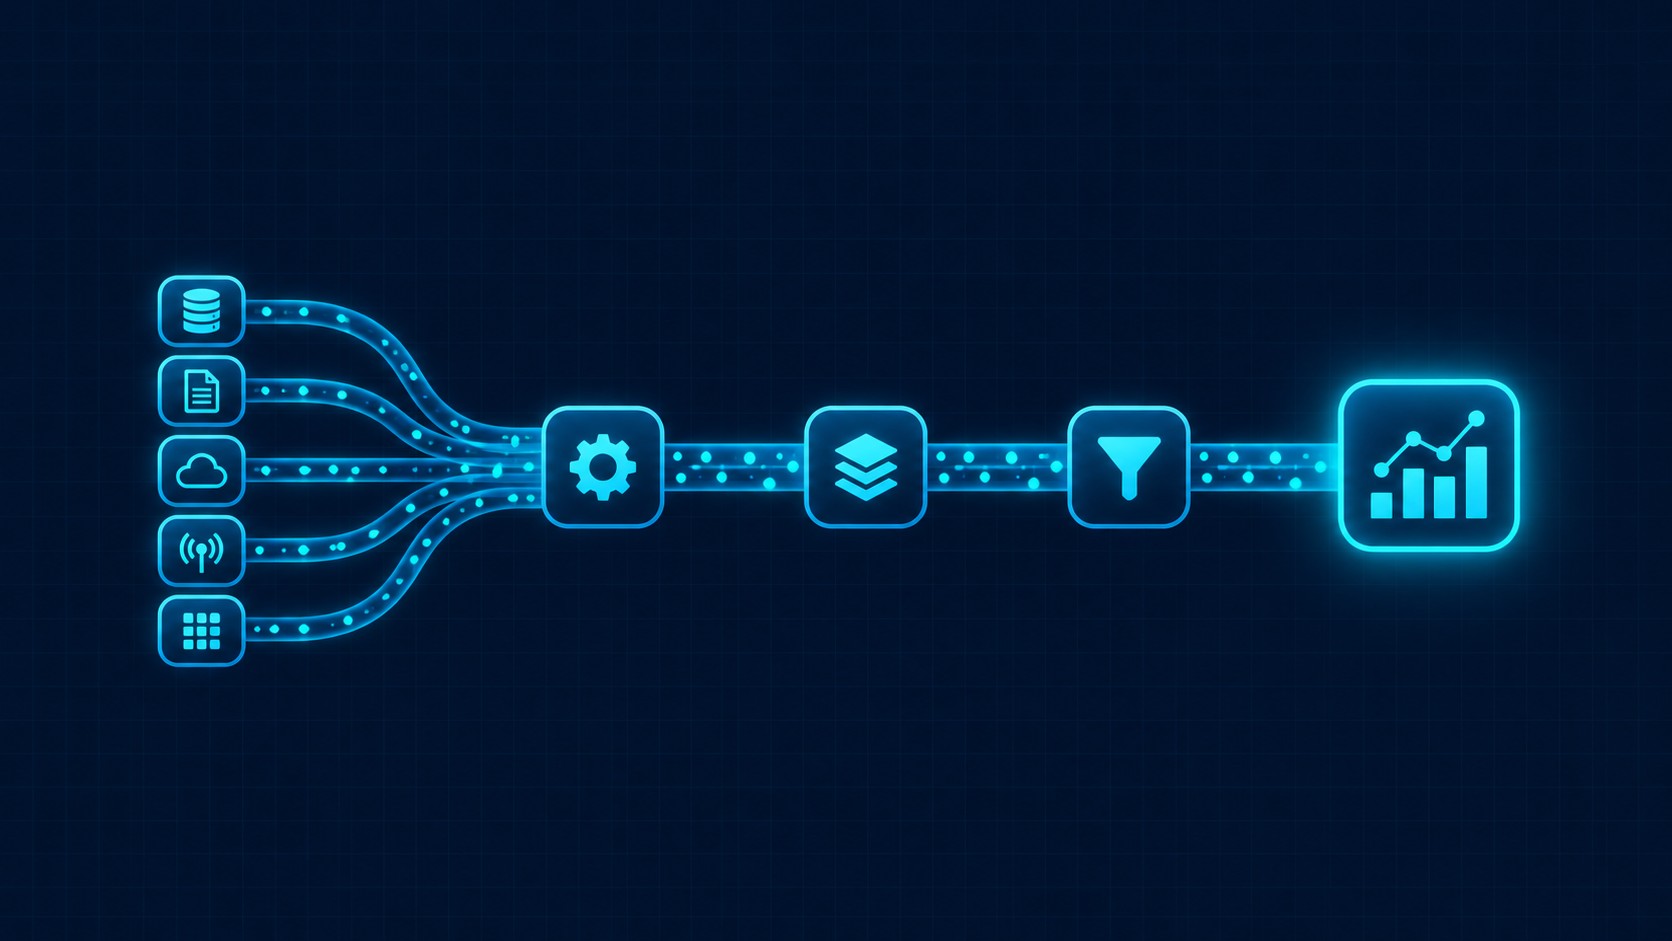
Data Pipeline (конвейер данных) — последовательность автоматизированных процессов, которые собирают данные из разнородных источников, перемещают и обрабатывают их, доставляя в системы назначения: хранилища, дашборды, ML-модели. По аналогии с производственным конвейером, данные проходят этапы один за другим — очистка, агрегирование, стандартизация — без участия человека на каждом шаге.
По данным Statista, только в 2020 году человечество создало 64,2 зеттабайта данных. Без автоматизированной обработки эти объёмы становятся неуправляемыми. Конвейеры данных закрывают три типа задач: интеграция разнородных источников, репликация между системами и виртуализация — доступ к распределённым хранилищам через единый интерфейс.
В статье разберём, из каких компонентов состоит дата пайплайн, чем отличаются ETL и ELT, как устроена оркестрация в Apache Airflow — и как построить конвейер за 7 шагов.
Конвейер данных — набор процессов и инструментов, которые автоматизируют сбор, перемещение и обработку данных от источников до точек потребления. Выход каждого этапа становится входом следующего — так устроена конвейерная обработка данных. Независимые этапы выполняются параллельно, что ускоряет общую пропускную способность.
Концепция не нова: методологии анализа данных CRISP-DM, KDD и SEMMA включают этапы извлечения, очистки и трансформации. Дата пайплайн автоматизирует именно эти операции — и добавляет мониторинг, управление доступом и восстановление после сбоев.
Данные поступают из разных источников: реляционные базы, NoSQL-хранилища, REST API, очереди событий, файловые системы, IoT-сенсоры. На другом конце — команды аналитиков, дата-сайентистов, бизнес-пользователей, которым нужны чистые и структурированные данные. Конвейер выполняет всю работу между этими точками — автоматически, по расписанию или по событию.
Три сценария, где он незаменим: интеграция разнородных данных из нескольких систем, репликация данных между хранилищами для резервирования и производительности, виртуализация данных — когда физически перемещать данные нет смысла, но аналитикам нужен единый интерфейс.
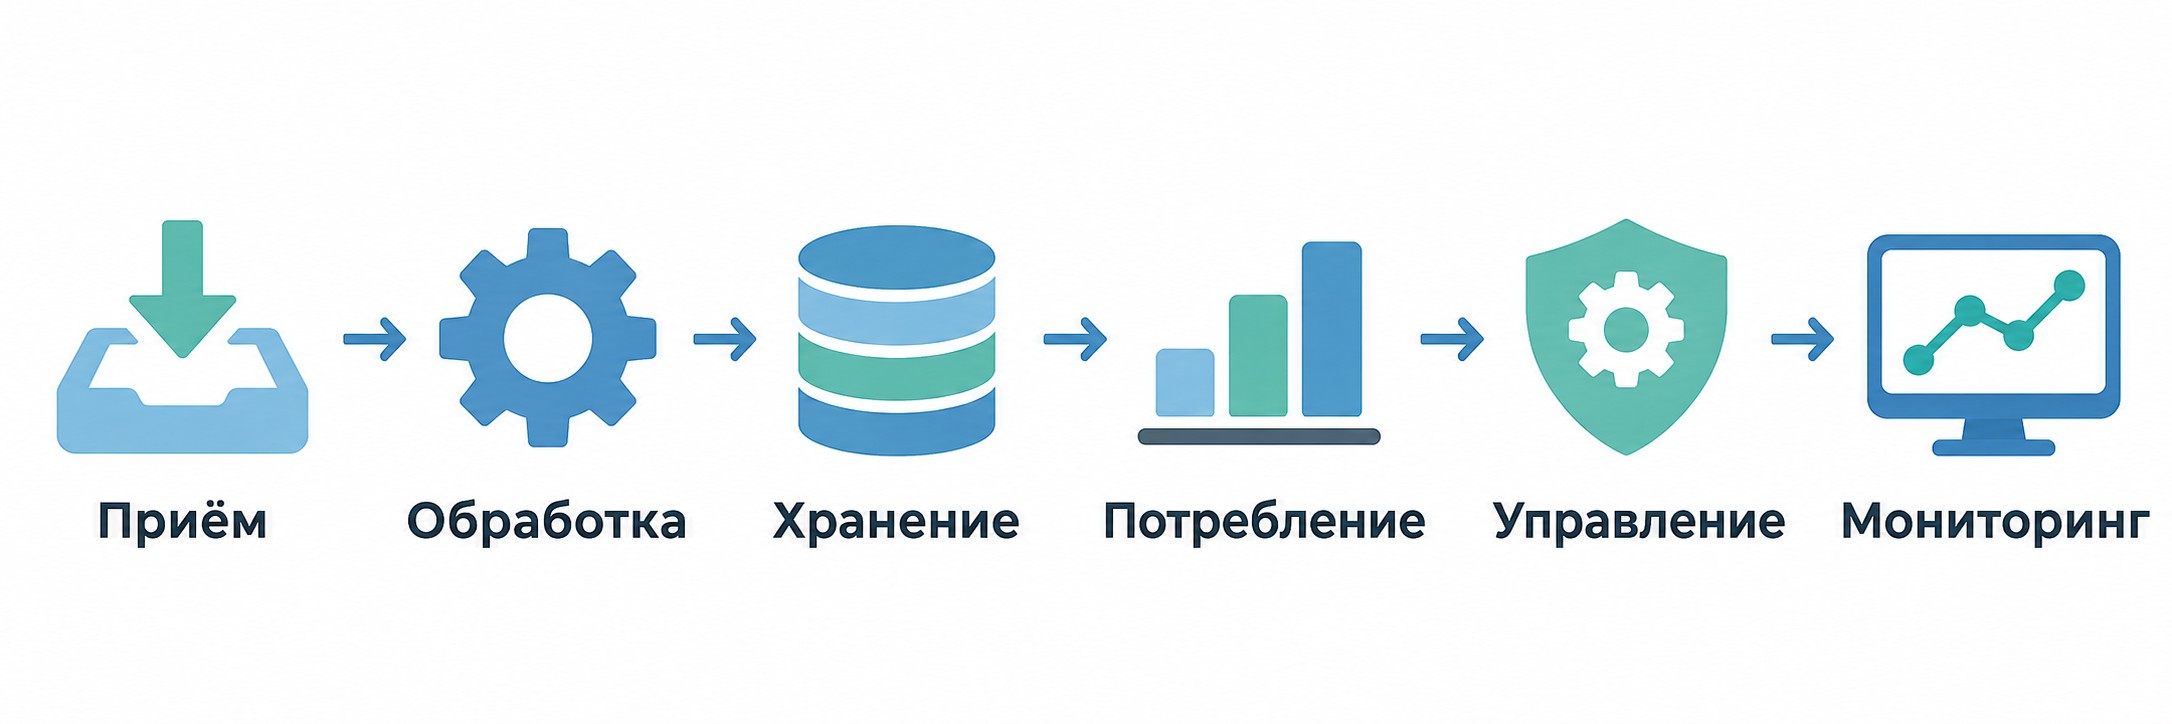
Data Pipeline состоит из шести функциональных слоёв. Каждый решает свою задачу, а вместе они обеспечивают сквозной поток от источника данных до потребителя.
Слой приёма (Ingestion Layer) — первая точка контакта. Извлечение данных происходит через API, push-механизмы, расписание или триггеры событий. Слой принимает как структурированные таблицы, так и неструктурированные файлы.
Слой обработки (Processing Layer) — самый ресурсоёмкий этап: очистка данных от дублей и ошибок, фильтрация, агрегирование, валидация схемы, дедупликация, преобразование данных в нужный формат. Здесь данные приобретают качество, пригодное для анализа.
Слой хранения (Storage Layer) — данные попадают в хранилище: Data Warehouse, Data Lake или Data Lakehouse. Выбор зависит от архитектуры конвейера и требований к запросам.
Слой потребления (Consumption Layer) — готовые данные доступны через BI-дашборды, ad-hoc запросы, ML-модели, API. Аналитики строят отчёты, дата-сайентисты обучают модели.
Слой управления и безопасности (Governance Layer) — контроль доступа, шифрование, аудит операций. Критичен для соответствия требованиям 152-ФЗ, GDPR и корпоративной политике безопасности данных.
Слой мониторинга — выявление узких мест, логирование ошибок и оповещения. Инструменты: Grafana, Datadog, PagerDuty. Без этого слоя сбои в конвейере обнаруживаются слишком поздно — уже после того, как повреждённые данные попали в отчёты.
Конвейеры данных нужны не всегда. Если источник один, а анализ одноразовый — конвейер избыточен. Но в трёх сценариях без него сложно обойтись.
Интеграция разнородных источников данных. Компания работает одновременно с CRM, ERP, аналитикой сайта, данными из социальных сетей и IoT-сенсоров. Форматы несовместимы, схемы различаются. Data Pipeline собирает всё в единую аналитическую базу, нормализует схемы и обеспечивает согласованность. Пример: образовательная платформа объединяет демографические данные учеников, показатели успеваемости и информацию о преподавателях в единый контур для управления качеством обучения.
Репликация данных. Конвейер непрерывно копирует данные в резервное хранилище. Это решает три задачи: производительность (читай из реплики, не нагружая основную базу), резервное копирование (точка восстановления при сбое) и целостность данных между геораспределёнными системами. При этом производственная база остаётся доступной для клиентов без деградации.
Виртуализация данных. Вместо физического перемещения конвейер создаёт единый виртуальный слой доступа к распределённым хранилищам. Аналитик видит «одну базу» — реально данные лежат в нескольких системах. Это снижает дублирование и затраты на хранение при сохранении полного качества данных для запросов.
Когда конвейер не нужен: один источник данных, анализ выполняется вручную раз в квартал, объём не превышает нескольких гигабайт. В таких случаях простой SQL-запрос справится без конвейерной инфраструктуры.
Конвейеры данных делятся на шесть основных типов по способу обработки и целевой архитектуре: пакетный, потоковый, Lambda, событийный (event-driven), облачный и Big Data Pipeline. Выбор типа определяется тремя факторами: природой данных, требованием к допустимой задержке и частотой обновления. Финансовые транзакции требуют миллисекундной реакции — нужен потоковый конвейер. Ежемесячная отчётность терпит пакетную обработку раз в сутки. Не менее важен характер источника: IoT-сенсоры генерируют непрерывный поток событий, а корпоративная ERP-система обновляет записи дискретно — по ночам или в конце недели. Правильный тип конвейера снижает латентность, нагрузку на источники и стоимость инфраструктуры.
Пакетный конвейер (batch pipeline) обрабатывает данные блоками за фиксированный период: за минуту, час, день или месяц. Задачи — сложные агрегации, аналитические отчёты, вычисления, которые требуют полного набора данных за период. Параллельная обработка нескольких блоков повышает общую пропускную способность. Инструменты: Talend, Pentaho, Informatica.
Потоковый конвейер обрабатывает каждое событие непрерывно, без накопления блока, — данные поступают и уходят в режиме реального времени. Применение: мониторинг финансовых рынков, обработка IoT-сигналов, анализ активности в социальных сетях, системы рекомендаций в e-commerce. Инструменты: Apache Kafka (backbone для стриминга), Apache Flink, Confluent.
Принципиальное различие — в допустимой задержке. Конвейер пакетной обработки принимает задержку от минут до часов. Потоковый конвейер данных рассчитан на миллисекунды — иначе теряется смысл обработки в реальном времени.
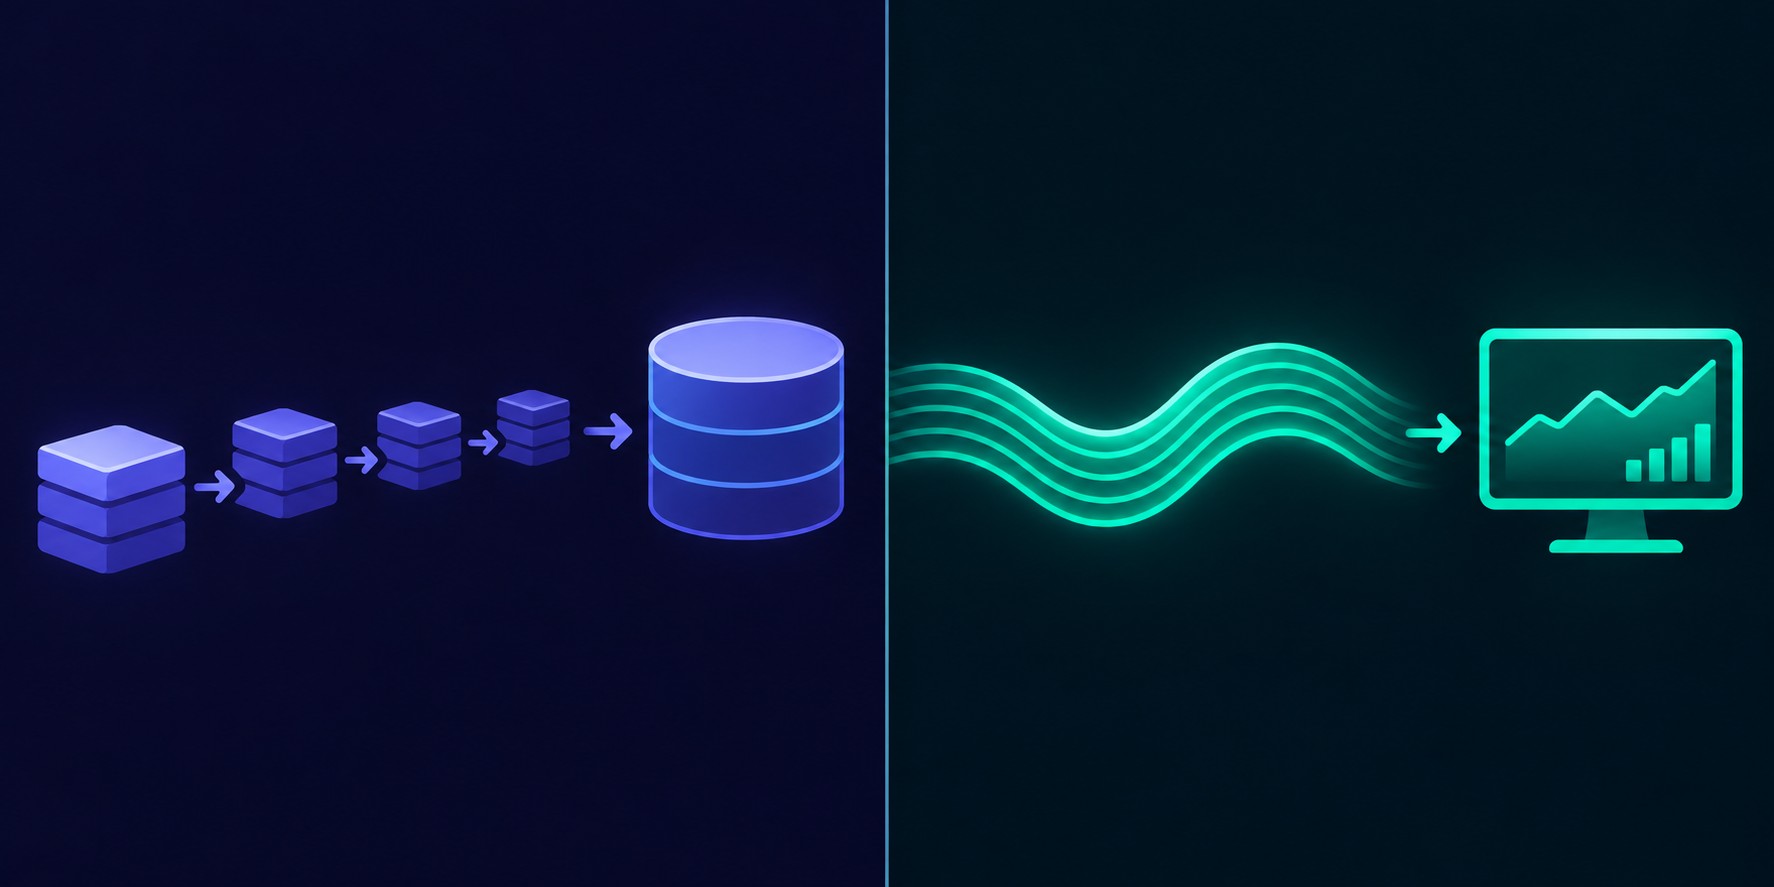
Архитектура Lambda решает задачу, когда одновременно нужны исторические данные с высокой точностью и анализ в реальном времени. Три слоя работают параллельно: пакетный слой обрабатывает исторические данные с полной точностью, потоковый слой (speed layer) обеспечивает низкую задержку для текущих событий, сервисный слой (serving layer) объединяет результаты для запросов. Данные хранятся в сыром формате — это позволяет повторно обработать историю при изменении бизнес-требований без потери данных.
Event-driven Pipeline (конвейер, управляемый событиями) запускается не по расписанию, а по триггеру: действие пользователя, системное уведомление, изменение данных в источнике. Это обеспечивает реакцию в реальном времени при минимальной нагрузке в периоды затишья. Реализации: Apache Kafka, AWS Lambda, Azure Event Grid.
Облачный конвейер — мост между локальными системами и облачной инфраструктурой. Масштабируется по модели pay-as-you-go: платите за реально использованные ресурсы. Провайдеры: AWS Data Pipeline, Google Cloud Dataflow, Azure Data Factory. Облачные решения снижают порог входа — не нужно администрировать собственный кластер.
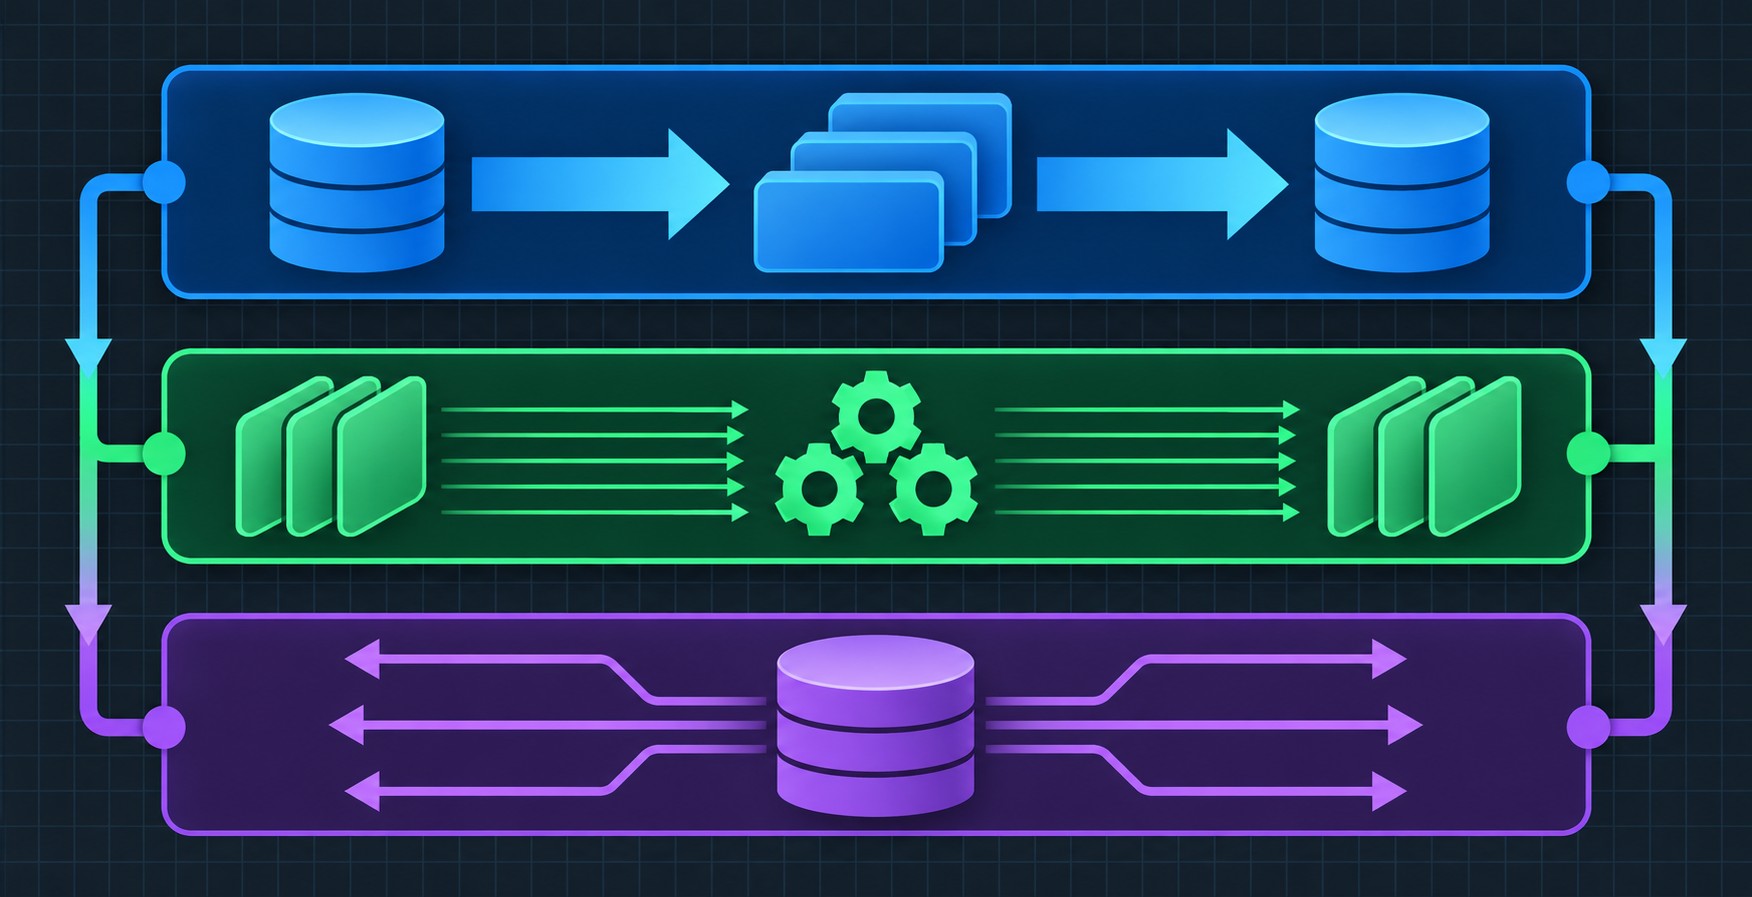
Big Data определяется тремя «V»: Volume (объём — петабайты), Velocity (скорость поступления) и Variety (разнообразие форматов). Каждое измерение предъявляет свои требования к конвейеру.
Velocity требует потокового конвейера с минимальной задержкой. Volume требует горизонтальной масштабируемости: данные обрабатываются параллельно на распределённом кластере. Variety означает поддержку структурированных, неструктурированных и полуструктурированных данных в одном конвейере.
Ключевой движок Big Data Pipeline — Apache Spark: распределённые вычисления на кластере, поддержка всех трёх типов данных, совместимость с HDFS, Amazon S3, Apache Kafka и основными облачными платформами.
ETL и ELT — два архитектурных подхода к построению конвейера данных. Оба описывают последовательность операций, но порядок трансформации принципиально разный.
ETL (Extract → Transform → Load): данные извлекаются из источников, трансформируются во внешней системе или промежуточном слое и только затем загружаются в целевое хранилище. Целевая система — Data Warehouse с жёсткой схемой. ETL гарантирует качество и целостность данных до загрузки: в хранилище попадают только валидированные, структурированные записи. Инструменты: Informatica PowerCenter, IBM InfoSphere DataStage, Talend, Pentaho.
ELT (Extract → Load → Transform): данные сначала загружаются в хранилище в сыром виде, трансформация выполняется внутри хранилища по мере необходимости. Целевая система — Data Lake или современный облачный DWH с большой вычислительной мощностью. Трансформация в ELT происходит на стороне хранилища, что особенно эффективно для Google BigQuery, Snowflake и AWS Redshift. Ключевой ELT-инструмент — dbt: SQL-команды выполняются внутри хранилища, вычисления — на его стороне, с полной git-интеграцией. Дополнительные инструменты: DuckDB, Fivetran.
Явная разница: в ETL трансформация происходит до загрузки, в ELT — после.
| Параметр |
ETL |
ELT |
|---|---|---|
| Последовательность | Extract → Transform → Load | Extract → Load → Transform |
| Целевое хранилище | Data Warehouse | Data Lake / Cloud DWH |
| Применение | Бизнес-отчётность, строгий формат, ACID | IoT, Big Data, ML-конвейеры |
| Скорость загрузки | Медленнее (трансформация до загрузки) | Быстрее (сырые данные сразу в хранилище) |
| Примеры инструментов | Informatica, IBM DataStage, Talend | dbt, Fivetran, DuckDB |
Когда выбирать ETL: бизнес-отчётность с жёсткими требованиями к формату, строгий контроль качества до загрузки, обязательные ACID-транзакции.
Когда выбирать ELT: большие объёмы IoT-данных, ML-конвейеры, когда скорость загрузки важнее немедленной готовности данных к запросам, а вычислительная мощность хранилища достаточна для трансформаций.
Выбор хранилища определяет архитектуру всего конвейера данных. Три варианта различаются по схеме, типам данных и режиму транзакций.
Data Warehouse (хранилище данных) работает по принципу schema-on-write (схема фиксируется до загрузки, данные должны ей соответствовать). Поддерживает ACID-транзакции. Принимает только структурированные данные. Поверх DWH строятся витрины данных для конкретных бизнес-функций. Платформы: Google BigQuery, Snowflake, AWS Redshift, Greenplum, Arenadata DB.
Data Lake (озеро данных) работает по принципу schema-on-read: данные хранятся как есть, схема применяется при чтении. Принимает любые типы данных — структурированные, неструктурированные, полуструктурированные. Загружать просто, запрашивать сложнее — без чёткой схемы запросы требуют дополнительной обработки. Встроенные транзакции отсутствуют. Платформы: Amazon S3, HDFS. Риск «болота данных»: без каталога метаданных Data Lake превращается в неуправляемое хранилище.
Data Lakehouse объединяет достоинства обоих подходов: транзакционность и структурированность DWH плюс поддержку разнородных форматов Data Lake. Реализации: Apache Iceberg, Delta Lake. Позволяет обрабатывать ML-данные и структурированную аналитику на одной платформе без дублирования инфраструктуры.
| Параметр |
Data Warehouse |
Data Lake |
Data Lakehouse |
|---|---|---|---|
| Схема | Schema-on-write | Schema-on-read | Schema-on-write + read |
| Транзакции | ACID | Нет | ACID (Iceberg / Delta) |
| Типы данных | Только структурированные | Все форматы | Все форматы |
| Платформы | BigQuery, Snowflake, Redshift | Amazon S3, HDFS | Apache Iceberg, Delta Lake |
Data Lakehouse объединяет Data Warehouse и Data Lake — транзакционность первого с гибкостью второго.
Хотите сменить профессию или повысить квалификацию?
Федеральный проект «Активные меры содействия занятости» даёт возможность пройти обучение бесплатно за счёт государства
Выбор инструментов определяется четырьмя критериями: бюджет, совместимость с текущей архитектурой, компетенции команды и тип задачи. Экосистема разделяется на две категории: инструменты, встроенные в облачные платформы (AWS, GCP, Azure), и независимые решения — open-source и коммерческие. Первые проще развернуть, если уже работаете в облаке; вторые дают больше гибкости. Дата-инженер выбирает стек исходя из всех четырёх критериев одновременно — универсального ответа нет.
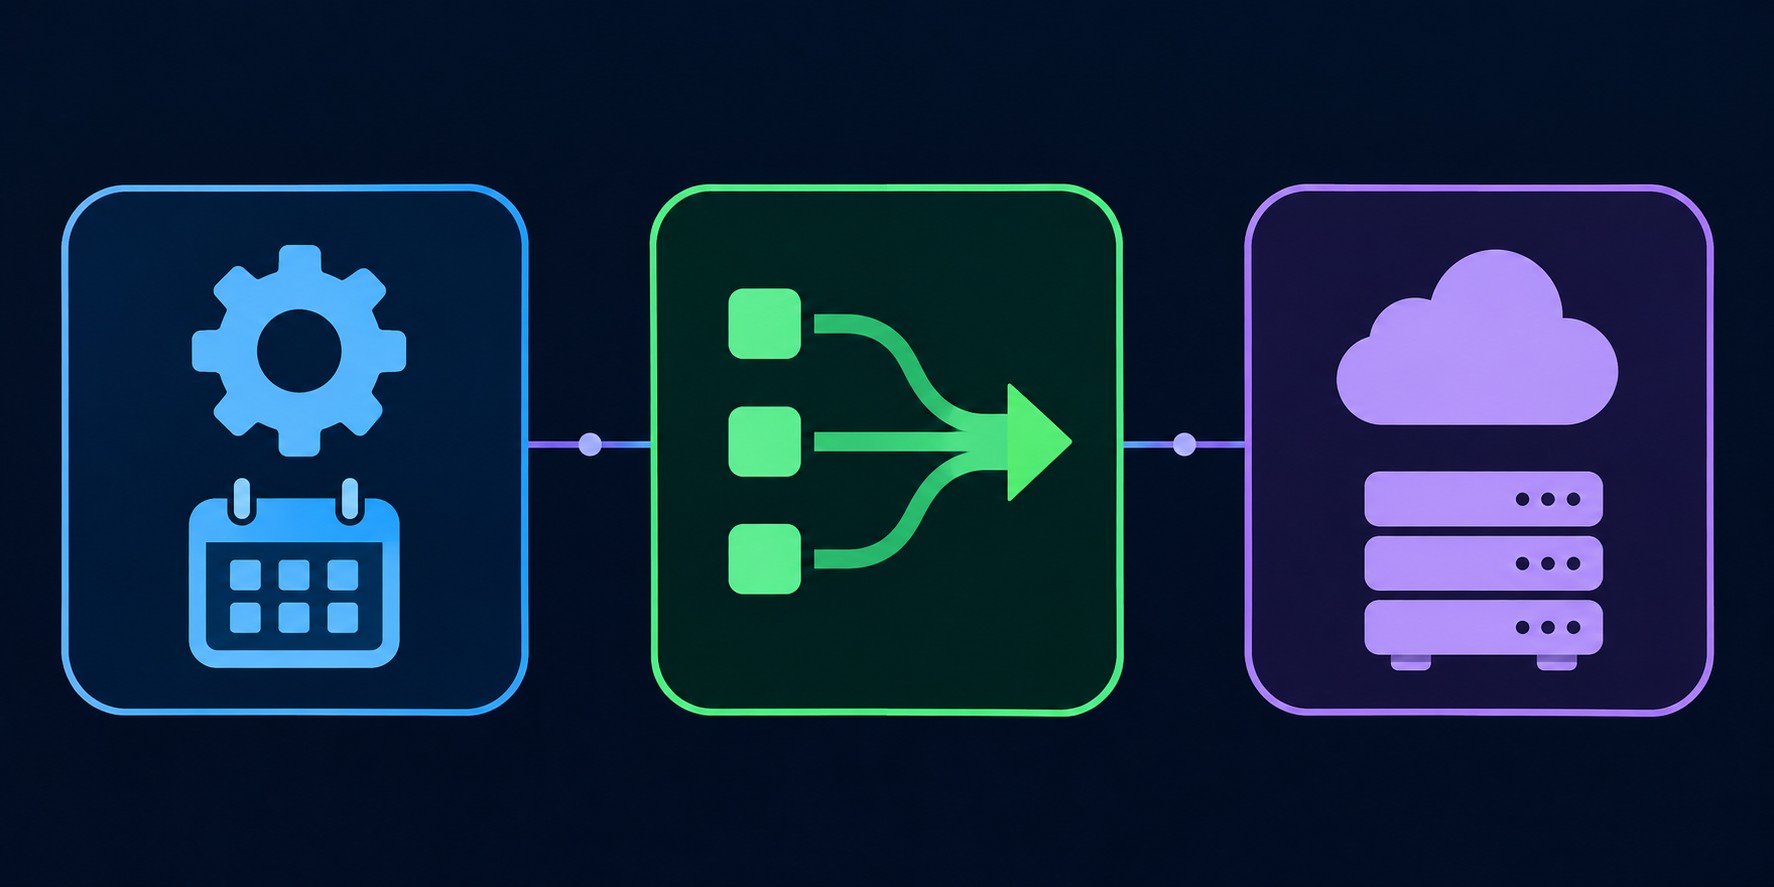
Оркестраторы управляют расписанием, зависимостями и мониторингом задач конвейера:
Автоматизация потоков: Apache NiFi — визуальный drag-and-drop маршрутизатор данных между системами.
Streaming backbone: Apache Kafka — распределённая платформа очередей событий, основа большинства event-driven и потоковых конвейеров. Apache Flink — потоковый движок с низкой задержкой и stateful-операциями (хранением состояния между событиями).
ETL batch-решения: Talend (open-source + коммерческий), Pentaho — классика для корпоративных пакетных конвейеров.
AWS: AWS Glue — serverless ETL, автоматически генерирует код на PySpark; AWS Data Pipeline — оркестрация задач с поддержкой on-premise и облака.
GCP: Cloud Dataflow — потоковая и пакетная обработка на основе Apache Beam; BigQuery Transfer Service — перенос данных в BigQuery без кода.
Azure: Azure Data Factory — интеграция в Microsoft-экосистему, визуальный конструктор конвейеров.
Коммерческие: Fivetran (ELT-коннекторы к 500+ источникам с поддержкой инкрементальной загрузки через CDC), Hevo Data (no-code), Informatica, Segment (для клиентских данных). CDC (Change Data Capture) — механизм захвата только изменившихся записей — снижает нагрузку на источник по сравнению с полной загрузкой.
Apache Airflow — open-source оркестратор рабочих процессов, созданный Airbnb в 2014 году и переданный в Apache Software Foundation. Сегодня это стандарт де-факто для оркестрации конвейеров данных в крупных data-командах.
Центральная концепция — DAG (Directed Acyclic Graph, направленный ациклический граф). Каждый узел DAG — это Task (задача), каждая стрелка — зависимость между задачами. «Ациклический» означает: данные движутся только вперёд, циклов нет. Независимые задачи запускаются параллельно — это ускоряет выполнение конвейера данных.
Задачи описываются на Python — не через командную строку и не через XML-конфиги. Веб-интерфейс Airflow показывает граф выполнения, логи каждой задачи и статусы в реальном времени. Пример типового конвейера: данные извлекаются из разрозненных источников и загружаются в единое постоянное хранилище данных по следующей цепочке — ежедневная выгрузка из API источника → очистка и валидация → трансформация → загрузка в Data Warehouse → уведомление команды.
Airflow интегрируется с облачными платформами: управляемый сервис в GCP — Google Cloud Composer, в AWS — Amazon MWAA (Managed Workflows for Apache Airflow), Azure предлагает собственный managed-вариант.
Сравнение с конкурентами: Airflow — зрелая экосистема, богатый UI, тысячи готовых операторов, но шаблонный Python-код; Prefect — современный Python-first подход, меньше boilerplate, проще для небольших команд; Luigi — минималистичный, подходит для простых конвейеров, слабый веб-интерфейс.
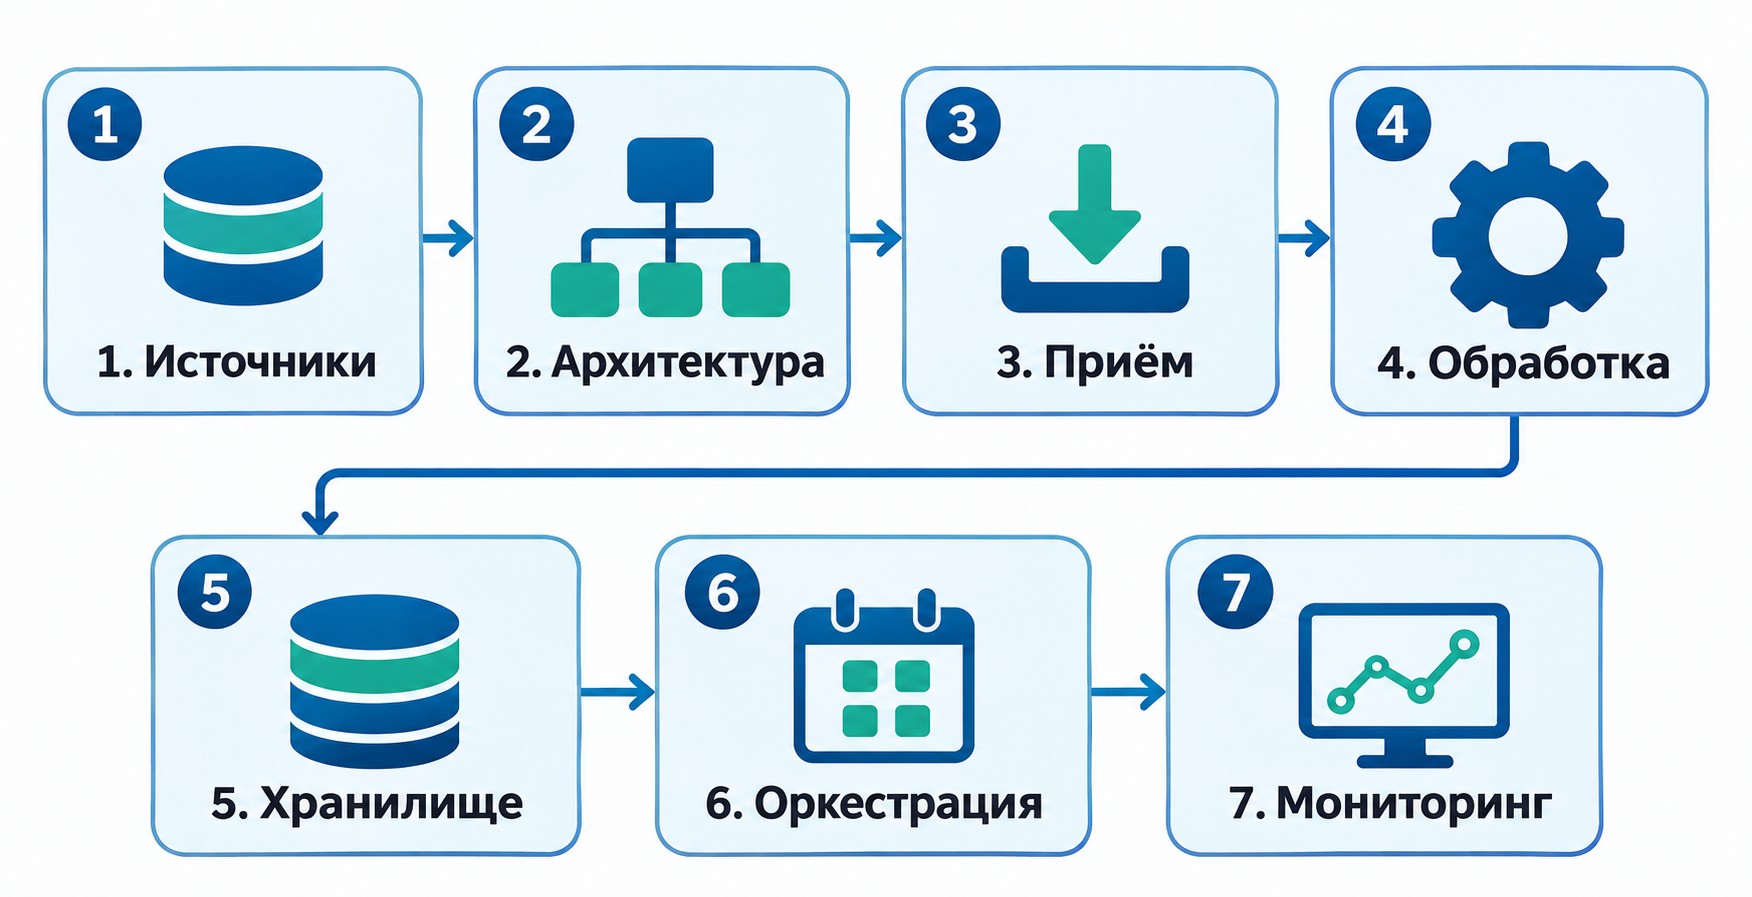
Создание конвейера данных — инженерная задача, которую решает Data Engineer. Универсальный процесс укладывается в семь шагов. Освоить аналитику данных с нуля можно на курсах по аналитике данных с господдержкой.
Шаг 1: Определить цель. Какие бизнес-вопросы должен закрывать конвейер? Каковы ожидаемые KPI — частота обновления данных, допустимая задержка, качество на выходе?
Шаг 2: Выявить стейкхолдеров. Аналитики, дата-сайентисты, бизнес-пользователи — у каждого свои требования. Собрать их до проектирования, а не после запуска.
Шаг 3: Выбрать источники данных. Внутренние системы (CRM, ERP, база продуктов) и внешние (REST API, открытые данные, IoT-сенсоры, очереди событий). Оценить доступность, частоту обновления и качество каждого источника данных.
Шаг 4: Выбрать стратегию загрузки. Три варианта: инкрементальная загрузка (только новые или изменённые записи по временным меткам — экономит ресурсы), полная загрузка (все данные каждый раз — проще, но дороже при больших объёмах), delta-загрузка через CDC (только изменения). Инкрементальная загрузка — оптимальный выбор для высокочастотных конвейеров с большими объёмами.
Шаг 5: Выбрать инструменты и архитектуру. Оркестратор, тип конвейера (batch / streaming / Lambda), хранилище. Критерии: бюджет, совместимость с текущим стеком, компетенции команды.
Шаг 6: Разработка, настройка и тестирование. Написать код конвейера, настроить интеграции, протестировать на реальных данных с проверкой граничных случаев и восстановления после сбоев.
Шаг 7: Мониторинг и оптимизация. Настроить алерты (Grafana, Datadog, PagerDuty), отслеживать узкие места, применять параллельную обработку, шардирование и партиционирование для масштабируемости.
Data Pipeline — автоматизированная система для перемещения и обработки данных из источников (баз данных, API, IoT-сенсоров) в системы назначения (хранилища, дашборды, ML-модели). По аналогии с производственным конвейером: данные «движутся» по этапам — очистка, агрегирование, стандартизация — без ручного участия.
ETL — частный случай Data Pipeline: конкретная архитектурная схема Extract → Transform → Load. Data Pipeline — более широкое понятие, включающее ETL, ELT, потоковые и событийные конвейеры. Не каждый конвейер является ETL, но каждый ETL — это конвейер.
ETL выбирают для бизнес-отчётности и хранилищ данных, где качество и целостность данных критичны до загрузки. ELT — для больших объёмов IoT и Big Data, когда важна скорость загрузки, а трансформация выполняется по мере необходимости в Data Lake.
DAG (Directed Acyclic Graph) — направленный ациклический граф, описывающий задачи конвейера и зависимости между ними. Каждый узел — задача (Task), каждая стрелка — зависимость. Airflow выполняет задачи в правильном порядке; независимые задачи запускаются параллельно.
Data Warehouse: schema-on-write, только структурированные данные, ACID-транзакции — легко использовать для аналитики. Data Lake: schema-on-read, любые форматы — легко загружать, сложнее запрашивать. Data Lakehouse объединяет достоинства обоих подходов.
Стратегия извлечения, при которой из источника берутся только новые или изменённые записи — по временным меткам или ID. Экономичнее полной загрузки и точнее delta-загрузки. Критически важна для высокочастотных конвейеров с большими объёмами данных.
Конвейеры данных разрабатывают и поддерживают инженеры данных (Data Engineers). Они проектируют архитектуру, пишут код, настраивают интеграции и мониторинг. Результаты работы конвейера используют аналитики данных, дата-сайентисты, разработчики и бизнес-пользователи.
Lambda Architecture — гибридный тип конвейера: пакетный слой обрабатывает исторические данные с высокой точностью, потоковый — обеспечивает анализ в реальном времени. Данные хранятся в сыром формате, что позволяет повторно обработать историю при изменении бизнес-требований без потери данных.
Оркестрация: Apache Airflow (open-source лидер), Prefect, Dagster. Streaming: Apache Kafka, Apache Flink. Трансформация: dbt, Talend, Fivetran. Облако: AWS Glue, Google Cloud Dataflow, Azure Data Factory. Выбор зависит от архитектуры, бюджета и стека команды.
Нет, если анализ одноразовый или источник один. Конвейер оправдан при регулярном объединении данных из разнородных источников, необходимости автоматизации обработки, репликации данных между системами или масштабировании аналитики на большие объёмы.
Подайте заявку — забронируйте место в группе
45 000 мест на 2026 год. Бесплатное обучение по федеральному проекту «Активные меры содействия занятости»